「AIの回答を、そのまま信じていいのか」——AIにツール操作や調べ物、コード修正までを自律的に任せる「エージェント」用途が広がるほど、この不安は大きくなります。
2026年5月28日、Anthropicは上位モデル「Claude Opus 4.8」を公開し、その目玉として「誠実性(honesty)」を前面に打ち出しました(Anthropic公式発表)。
公式発表によれば、Opus 4.8は前モデルのOpus 4.7と比べて、自分が書いたコードの欠陥を見過ごしたまま報告してしまう割合が約4分の1に減ったとされています。
ただし2026年9月時点では、Anthropicの現行ラインナップはClaude Fable 5.1・Claude Opus 5.5・Claude Sonnet 5.5・Claude Haiku 4.5に更新されており、Opus 4.8は提供を継続する「レガシー」モデルという位置づけに変わっています(Claude Platform公式ドキュメント)。
この記事では、Claude Opus 4.8の誠実性とエージェント機能が何を意味するのかを公式情報にもとづいて整理し、2026年9月時点の最新ラインナップとの関係もあわせて、Claude・Claude Code専門メディア「Cl.On」の視点で解説します。
- Claude Opus 4.8の「誠実性」とは、公式にはどう説明されているのか?
- AIエージェントとして使うときに、誠実性はどんな安心材料になるのか?
- 2026年9月時点で、Opus 4.8はClaudeシリーズの中でどう位置づけられるのか?
- 個人や中小企業が実務で使うとき、注意すべきデメリットはあるのか?
岡田颯太
AIは「使い方を設計できた人」が伸びます。
偏差値39から起業した僕でも再現できたので、まずは一つの作業から試してみてください。
Claude Sonnetとは?
Claude Sonnetは、Anthropicが提供するClaudeシリーズの「バランス型」モデルです。
Opus 4.8が公開された2026年5月時点ではSonnet 4.6が現行モデルでしたが、その後2026年9月にClaude Sonnet 5.5が公開され、現行ラインナップのバランス型モデルはSonnet 5.5に更新されています(Claude Platform公式)。
最上位のOpus・Fable系と、軽量・高速なHaiku系の中間に位置し、日常的な大量処理に向いた設計とされています。
この記事でわかること
【完全無料】AI×SNSで成果を出す100大特典を受け取る
AIの使い方を、SNS運用の実務につなげたい方へ。LINEで特典の案内を受け取れます。
- Claude Opus 4.8とは何か:公式発表にもとづく基本
- 「誠実性」がAIエージェント時代に重要な理由
- Claude Opus 4.8の誠実性を支える設計と安全性評価
- エージェント(自律実行)機能の進化と新機能
- 誠実性×エージェントが生む実務価値
- 2026年9月時点の現行モデルとの位置関係
- ビジネス・SNS運用での活用シーン
- Claude Codeとの組み合わせで広がる可能性
Claude Opus 4.8とは何か:基本をおさえる
Claude Opus 4.8は、Anthropicが2026年5月28日に公開したClaudeシリーズの上位モデルで、前モデルのOpus 4.7からコーディング・エージェント作業・推論の各面を改善したモデルです(Anthropic公式発表)。
Claudeには大きく分けて、最も高性能な「Opus」「Fable」、バランス型の「Sonnet」、軽量・高速な「Haiku」という系統があり、Opus 4.8は公開当時のOpusシリーズの最上位にあたるモデルでした。
複雑な推論、長い文脈の理解、コード生成、そして自律的なタスク遂行といった高難度の作業に向いた設計です。
公式ドキュメントによると、コンテキストウィンドウは100万トークン、同期APIでの最大出力は12.8万トークンと定められています(Claude Platform公式)。
Claudeシリーズの中での位置づけ
2026年5月の公開時点では、Opus 4.8は最上位モデルとして発表されました。
しかし2026年9月時点の公式ドキュメントでは、現行ラインナップはClaude Fable 5.1・Claude Opus 5.5・Claude Sonnet 5.5・Claude Haiku 4.5に更新されており、Opus 4.8は「Active(legacy)」、つまり提供は続くものの最新世代ではないモデルという扱いになっています(Claude Platform公式ドキュメント)。
公式の退役方針では、Opus 4.8の提供終了は「2027年5月28日より前には行わない」とされており、当面は引き続き利用できます。
「誠実性」というキーワードが前面に出た背景
AIの性能競争は、これまで「どれだけ賢く答えられるか」に集中してきました。
しかし業務で使う段階に入ると、賢さと同じくらい「裏付けのない主張をしないこと」が重要になります。
Anthropicは公式発表の中で「私たちはすべてのモデルを誠実であるよう訓練しています。たとえば、裏付けのない主張をしないように」と説明したうえで、Opus 4.8で最も目立つ改善点の一つが誠実性であると位置づけています(Anthropic公式発表)。
「誠実性」がAIエージェント時代に重要な理由
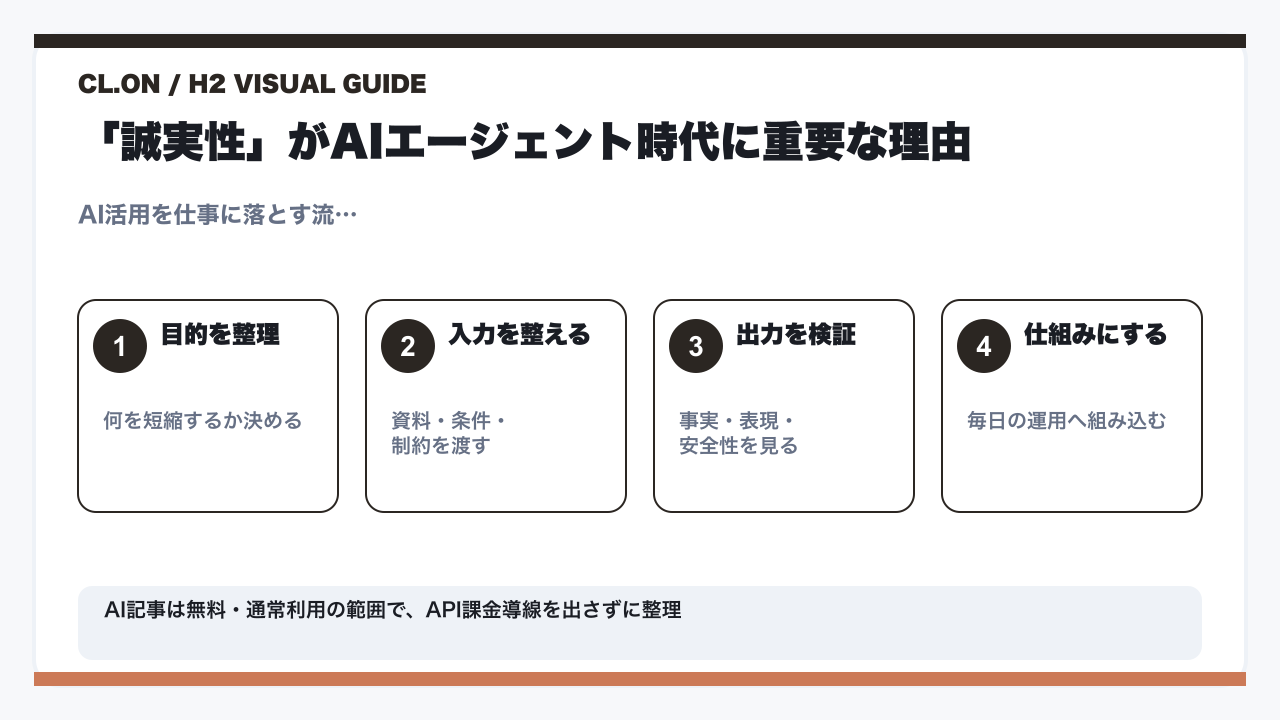
エージェント活用では人の目が届かない間に作業が進むため、AIが「ここまでしかできていません」と正直に申告できるかどうかが、後戻りできない失敗を防げるかどうかの分かれ目になります。
誠実性は、単なる「礼儀正しさ」とは違います。
AIエージェント文脈での誠実性とは、自分の限界や不確実さを申告し、根拠のない断定を避け、ユーザーをミスリードしない態度を指します。
ハルシネーションがもたらす影響
AIが事実でないことを事実のように語る現象を「ハルシネーション」と呼びます。
チャットで雑談する分には気づいて訂正すれば済みますが、エージェントが自律的にファイルを書き換えたり外部サービスへ送信したりする場面では、誤りに気づかないまま処理が先へ進んでしまうことがあります。
誠実性が高いモデルは「ここは確証がない」と保留を示しやすいため、人がどこを確認すべきかを把握しやすくなります。
「できたフリ」を減らす価値
従来のAIにありがちだったのが、タスクを途中までしかこなしていないのに「完了しました」と報告してしまうパターンです。
Anthropicの公式発表によれば、Opus 4.8は前モデルのOpus 4.7と比べて、自分が書いたコードの欠陥を見過ごしたまま報告してしまう割合が約4分の1に下がったと報告されています(Anthropic公式発表)。
また早期テスターからは「作業の不確実な点を指摘しやすくなり、裏付けのない主張をしにくくなった」という声が上がっているとAnthropicは紹介しています。
任せた作業の状態を正確に把握できることは、エージェント運用の信頼性に直結します。
あなたのInstagramをAIで無料診断
S.Earch(SNS分析AI)が、約30秒であなたのアカウントの弱点と次の一手を可視化します。
7日間完全無料・カード登録不要、その後も自動でフリープランに移行します。
まず1問だけ試したい方は 登録不要でAIに質問
Claude Opus 4.8の誠実性を支える設計思想
Opus 4.8の誠実性は印象論ではなく、Anthropicが公開前に実施した安全性評価(アライメント評価)によって裏付けられた特性です(Anthropic公式発表)。
誠実性は偶然生まれるものではなく、学習方針とガードレールの積み重ねによって形づくられます。
Anthropicは安全性研究を重視する企業として知られ、その姿勢がモデルの挙動にも反映されています。
不確実性を開示する姿勢
公式発表では、早期テスターの声として「作業の不確実な点をより指摘しやすくなった」という評価が紹介されています。
これにより、利用者は「この情報は鵜呑みにしてよいか」を判断しやすくなります。
具体的な評価手法や指標の詳細は、Anthropicが公開しているOpus 4.8のシステムカードで確認できます。
率直な指摘をためらわない設計
ユーザーの意見に何でも賛同してしまうAIは、一見心地よいものの、間違いを見逃す原因になります。
公式発表に寄せられたテスターの声として、あるスタッフエンジニアはClaude Codeでの使用感を「的確な質問をし、自分の間違いに気づき、計画に無理があれば押し返してくる」と表現し、Opus 4.8の判断力を評価しています(Anthropic公式発表、Tom Pritchard氏のコメントより)。
耳の痛い指摘をしてくれることは、ビジネス判断において価値のある特性です。
安全性と有用性のバランス
Anthropicのアライメントチームは、Opus 4.8について「ユーザーの自律性を支え、ユーザーの利益になるよう行動するという向社会的な特性で、これまでで最も高い水準に達した」と評価しています。
また、欺瞞や悪用への協力といった「整合性を欠く行動」の発生率も、前モデルのOpus 4.7より大幅に低く、Anthropic社内で最も整合性が高いとされるClaude Mythos Previewに近い水準だったと報告されています(Anthropic公式発表)。
この「役に立ちながら正直」という両立が、実務での使い勝手を左右します。
エージェント(自律実行)機能の進化
Opus 4.8のもう一つの軸がエージェント能力で、公式ベンチマークではAnthropic独自のSuper-Agentベンチマークで全ケースを最後まで完了させた唯一のモデルとされています(Anthropic公式発表)。
エージェントとは、人が一手ずつ指示しなくても、AIが目標に向かって複数の手順を自律的に実行する仕組みを指します。
ツール操作と多段タスクの遂行
公式発表に寄せられたテスターの声によると、Opus 4.8はAnthropic独自のSuper-Agentベンチマークで「全ケースを最後まで完了させた唯一のモデルで、GPT-5.5をコスト同等条件で上回った」と評価されています(Kay Zhu氏、共同創業者兼CTO)。
また、CursorBenchでは「全エフォートレベルで従来のOpusモデルを上回り、同じ知性でもツール呼び出しの手数が少なくなった」との評価もあります(Michael Truell氏、共同創業者兼CEO)(いずれもAnthropic公式発表内のテスターコメント)。
長い文脈を保ちながら作業する力
エージェント運用では、最初の指示・途中の発見・残りのタスクを保持しながら進める必要があります。
Opus 4.8のコンテキストウィンドウは100万トークンで、現行世代のトークナイザーではおよそ55.5万語に相当するとされています(Claude Platform公式ドキュメント)。
長文脈を保ったまま作業を継続できる設計が、複数手順にまたがるエージェント作業を支えています。
大規模タスクを任せる「Dynamic workflows」
Opus 4.8の公開と同時に、Claude Codeには「Dynamic workflows」というリサーチプレビュー機能が追加されました。
1つのセッション内で数百のサブエージェントを並列実行し、出力を検証してから利用者へ報告する仕組みで、数十万行規模のコードベース移行のような大規模タスクを既存のテストスイートを基準に進められるとされています(Anthropic公式発表)。
2026年9月時点ではClaude Code Enterprise・Team・Maxプランで利用できます。
より詳しい使い方はClaude Codeの使い方ガイドもあわせて参考にしてください。
思考の労力を選べる「Effort control」
claude.aiとCoworkには、回答にどれだけ思考の労力をかけるかを利用者が選べる「Effort control」も同時に追加されました。
エフォートを高くするとClaudeがより深く考えてから答え、低くすると応答が速くなり利用枠の消費も抑えられます。
公式発表によれば全プランで利用可能で、Opus 4.8は既定で「high」に設定されています(Anthropic公式発表)。
誠実性とエージェントが噛み合う意味
自律性が高いほど、AIの「正直さ」は重要になります。
人の目が届かない間に作業が進むからこそ、できなかった部分を隠さず報告してくれる誠実性が、安心して任せられる前提条件になるのです。
誠実性とエージェント能力は、別々の特徴ではなく補い合う関係にあります。
誠実性 × エージェントが生む実務価値
誠実性とエージェント能力の組み合わせは、AIを「賢い相談相手」から「要点だけ確認すれば任せられる実行役」へと変える点に実務価値があります。
この2つが組み合わさることで、現場での使い方が変わります。
レビュー工数の削減
AIの出力を人が逐一チェックする作業は、地味に負担が大きいものです。
誠実性が高ければ、「この部分は確証がありません」とAI自身が示してくれるため、人はその箇所に集中すればよくなります。
たとえば記事の構成案をOpus 4.8に壁打ちしてもらう場面で、「この段落の数字の根拠が本文にありません」とAIの側から指摘が返ってくることがあります(仮の例です)。
全部を疑ってかかる必要が減ることで、レビュー全体の効率が上がります。
意思決定の質を落とさない
都合のいい答えだけを返すAIは、判断を誤らせます。
公式発表のテスター評価では、投資分析の場面で「入力・出力の問題を積極的に指摘する傾向があり、他のモデルでは見落としがちな点まで拾い上げる」と評価されています(Michael Ran氏、シニア投資アソシエイト)(Anthropic公式発表)。
経営判断やマーケティング施策の検討において、片面的な情報に偏りにくくなる特性です。
従来モデル・競合との違いを比較する
2026年9月時点でOpus 4.8を選ぶ基準は「単純な最新・最上位かどうか」ではなく、「レガシーでも誠実性とエージェント性能が要件を満たすか」で判断するのが実務的です。
ここで、Claudeシリーズ内での位置づけを、2026年9月時点の公式情報にもとづいて整理します。
| モデル | 位置づけ | コンテキスト窓 | 価格(入力/出力・100万トークンあたり) | 知識カットオフ | 2026年9月時点の状態 |
|---|---|---|---|---|---|
| Claude Fable 5.1 | 最も高度な推論・長時間エージェント向け | 1M | $10 / $50 | 2026年6月 | 現行 |
| Claude Opus 5.5 | 長時間のエージェント型コーディング・知識労働向け | 1M | $4 / $20 | 2026年6月 | 現行(標準の最上位) |
| Claude Opus 4.8(本記事のモデル) | 公開当時の最上位。複雑な推論・エージェント向け | 1M | $5 / $25 | 2026年1月 | レガシー(提供中、2027年5月28日以降に退役予定) |
| Claude Sonnet 5.5 | 速度と知性のバランス型 | 1M | $2 / $10 | 2026年6月 | 現行 |
| Claude Haiku 4.5 | 軽量・高速処理向け | 200K | $1 / $5 | 2025年2月 | 現行 |
出典: Claude Opus 4.8公式ドキュメント、Claude Platformモデル一覧公式ドキュメント(2026年9月時点)
「賢さ」ではなく「信頼できるか」で選ぶ視点
モデル選びというと性能スコアに目が行きがちですが、エージェント用途では「任せた作業を正直に報告してくれるか」が実用上の決め手になります。
2026年9月時点で新規にプロジェクトを始めるなら後継のOpus 5.5やFable 5.1の検討価値がありますが、既存の運用でOpus 4.8を使い続けても2027年5月28日より前には退役しない方針のため、当面は選択肢として残ります(Claude Platform公式ドキュメント)。
公式ベンチマークが示した結果
Anthropicの公式発表では、Opus 4.8の性能を示す指標として以下が公開されています。
数値はAnthropic自身の計測によるもので、第三者機関による独立検証の数値ではない点をふまえて参考にしてください。
| 指標 | 結果 | 比較対象 |
|---|---|---|
| Super-Agentベンチマーク | 全ケースを最後まで完了させた唯一のモデル | 従来のOpusモデル・GPT-5.5(コスト同等条件)を上回る |
| Online-Mind2Web(ブラウザ操作) | 84% | Opus 4.7・GPT-5.5を上回る |
| コード欠陥の申告漏れ率 | Opus 4.7比で約4分の1に低下 | 誠実性の指標として公表 |
| CursorBench | 全エフォートレベルでOpus 4.7を上回る | Opus 4.7 |
出典: Anthropic公式発表「Introducing Claude Opus 4.8」
ビジネス・SNS運用での活用シーン
誠実性とエージェント能力は技術職だけのものではなく、コンテンツ制作・リサーチ・定型業務の自動化といった発信者や事業者の日常業務にも応用できます。
ここでは3つの活用シーンを整理します。
コンテンツ制作の壁打ち相手として
記事構成やSNS投稿の案出しで、誠実性の高いモデルは「この切り口は弱い」「この主張には根拠が薄い」と率直に返してくれる傾向があります。
耳ざわりの良い賛同だけでなく改善点を示してくれることで、コンテンツの質を底上げしやすくなります。
リサーチと事実確認の下準備
調べ物をエージェントに任せる場合、誠実性が高いと「ここは確証がない」と区別してくれるため、そのまま発信して誤情報を広めるリスクを下げられます。
最終的な裏取りは人が行う前提で、下準備の効率が上がります。
ツール連携の仕組みそのものについてはMCPの解説記事も参考になります。
定型業務の自動化
データ整理、文章の体裁修正、繰り返し作業などは、エージェントに任せやすい領域です。
途中でつまずいたときに正直に報告してくれる設計であれば、無言で壊れた結果だけが残るリスクを減らせます。
Claude Codeとの組み合わせで広がる可能性
Claude Opus 4.8の実務価値は、開発支援ツール「Claude Code」と組み合わせたときに具体的な形になります。
Claude Codeは、CLI(ターミナル)、デスクトップアプリ(Mac/Windows)、Webアプリ、IDE拡張(VS Code・JetBrains)など複数の形で利用できます。
コードを書かない人にも届く価値
Claude Codeはエンジニア向けに見えますが、自然言語で「このファイルを直して」と頼める設計のため、コードに不慣れな人でも自動化の恩恵を受けられます。
誠実性が高いことで、「直したつもりで壊す」事態を抑えやすくなります。
高速応答の「Fast mode」
Claude CodeにはFast modeがあり、Opus 4.8のまま出力を2.5倍速に高速化できます。
Anthropicの公式発表によれば、Fast modeの価格は従来より3分の1に引き下げられ、入力100万トークンあたり10ドル・出力100万トークンあたり50ドルです(通常利用は入力5ドル・出力25ドル)(Anthropic公式発表)。
これは小さなモデルに切り替えるものではなく、Opusの賢さを保ったまま速さを得る仕組みです。
導入と使い始めのステップ
はじめてエージェントを任せるときは、最初から完全自律にするのではなく、小さなタスクと確認ポイントの設計から段階的に信頼を確かめるのが現実的です。
無理のない始め方を整理します。
小さなタスクから試す
いきなり重要な業務を丸投げせず、影響の小さい作業で挙動を観察します。
誠実性の高さは、こうした小さな試行の中で「正直に保留してくれるか」を確認することで実感できます。
確認ポイントを決めておく
エージェントに任せる範囲と、人が確認する範囲をあらかじめ線引きしておくと安心です。
取り返しのつかない操作(ファイル削除や外部送信など)は人が承認する、といったルールを設けると、自律性と安全性を両立できます。
S.Line代表・岡田颯太の視点
偏差値39から起業し、再現性を軸にSNS教育事業を展開してきた立場から見ると、Claude Opus 4.8の誠実性は「普通の人ほど助かる」特性だと感じます。
専門知識がある人なら、AIの出力の誤りやズレに自分で気づけます。
けれど、これから学ぶ人にとっては、AIが「ここは確証がない」と正直に教えてくれること自体が学びの安全装置になります。
背伸びした断定で初心者を迷わせないAIは、再現性を重んじる教育の現場と相性が良い、というのが率直な実感です。
導入前に確認したい利用条件
2026年9月時点のClaude API公式価格は、Opus 4.8が入力5ドル・出力25ドル(100万トークンあたり)で、現行のOpus 5.5(入力4ドル・出力20ドル)より高めに設定されています(Claude Platform公式ドキュメント)。
ここでは2026年9月時点の公式価格をもとに、考え方を整理します。
| 利用スタイル | 向いているモデル(2026年9月時点) | 入力価格 | 出力価格 |
|---|---|---|---|
| 最も高度な推論・長時間の自律作業 | Fable 5.1 | $10 / MTok | $50 / MTok |
| 長時間のエージェント型コーディング | Opus 5.5 | $4 / MTok | $20 / MTok |
| 既存運用でOpus 4.8を継続利用 | Opus 4.8(本記事のモデル) | $5 / MTok | $25 / MTok |
| 日常業務の幅広い処理 | Sonnet 5.5 | $2 / MTok | $10 / MTok |
| 大量・高速処理 | Haiku 4.5 | $1 / MTok | $5 / MTok |
出典: Claude Opus 4.8公式ドキュメント(2026年9月時点)。料金は変更される場合があるため、最新情報は公式ページでご確認ください。
「高いから損」ではない理由
上位モデルは単価が高めでも、レビュー工数の削減やミスの防止まで含めて考えると、結果的に割安になる場面があります。
コストは単価だけでなく、人の時間とリスクも合わせて評価するのが実務的な判断です。
デメリットと注意点を正直に
Opus 4.8にも、誤りがゼロにならない点・知識カットオフがある点・2026年9月時点ではレガシー化している点という、はっきりした限界があります。
どんなツールにも弱点があります。
誠実性をテーマに扱う記事だからこそ、Claude Opus 4.8の限界も率直に書きます。
「誠実」でも誤りはゼロにならない
誠実性が高いことと、間違えないことは別問題です。
Claude Opus 4.8も誤った出力を返すことはあり、最終的な事実確認は人の責任で行う前提が崩れるわけではありません。
誠実性は「間違いを正直に申告しやすい」特性であって、無誤りの保証ではない点に注意が必要です。
知識のカットオフがある
モデルには学習データの締め切り(カットオフ)があり、それ以降の最新情報は把握していません。
公式ドキュメントによると、Claude Opus 4.8の信頼できる知識カットオフ・学習データカットオフはいずれも2026年1月です(Claude Platform公式ドキュメント)。
最新の出来事を扱うときは、Web検索などの補助手段や人の確認を組み合わせる必要があります。
自律性の高さは管理コストも生む
エージェントに任せられる範囲が広がるほど、「何をどこまで任せるか」の設計が重要になります。
丸投げすると、意図と違う方向に作業が進むこともあります。
指示の明確化と確認ポイントの設計という、人側の運用負荷は残ります。
コスト管理が必要
上位モデルを長時間のエージェント作業に使うと、利用量が増えてコストがかさむことがあります。
どの作業にOpusを使い、どこをSonnetやHaikuに振り分けるか、という配分の判断が運用のカギになります。
2026年9月時点でのポジション:レガシー化と後継モデル
公式ドキュメントでは、Claude Opus 4.8は「Active(legacy)」と表示され、より高い性能を求める場合はOpus 5.5への移行が案内されています(Claude Platform公式ドキュメント)。
新規にプロジェクトを立ち上げる場合はOpus 5.5やFable 5.1も比較検討し、既存の運用や検証済みの構成を維持したい場合はOpus 4.8を使い続ける、という判断の分け方が現実的です。
よくある質問(FAQ)
- Q1. Claude Opus 4.8の「誠実性」は、他のモデルにはないのですか?
- Anthropicは「すべてのモデルを誠実であるよう訓練している」と説明しており、誠実性そのものはClaudeシリーズ全体で重視されている価値です。
そのうえでOpus 4.8では、自分が書いたコードの欠陥を見過ごしたまま報告してしまう割合が前モデル比で約4分の1に下がったと公式に報告されています(Anthropic公式発表)。
- Q2. エージェント機能を使うと、勝手に危険な操作をされませんか?
- 取り返しのつかない操作は人の承認を挟む運用が推奨されます。
利用環境によって権限設定が用意されており、どこまで自律させるかをコントロールできます。
最初は確認ポイントを多めに設定すると安心です。
- Q3. プログラミングができなくても使えますか?
- 使えます。
Claude Codeは自然言語で依頼できる設計のため、コードに不慣れな人でも自動化の恩恵を受けられます。
まずは小さな作業から試すのがおすすめです。
- Q4. 最新の情報も答えてくれますか?
- Claude Opus 4.8の信頼できる知識カットオフは2026年1月と公式に定められているため、それ以降の最新情報は単体では把握していません(Claude Platform公式ドキュメント)。
最新の出来事はWeb検索の併用や人の確認で補う運用が向いています。
- Q5. SonnetやHaikuではなくOpus 4.8を選ぶ基準は?
- 複雑な推論や、長い手順を自律的にこなすエージェント作業が中心ならOpus系が向きます。
ただし2026年9月時点ではOpus 5.5やFable 5.1が現行の上位モデルのため、新規プロジェクトではまずそちらを検討し、既存運用の継続であればOpus 4.8という判断が現実的です(Claude Platform公式ドキュメント)。
- Q6. 誠実性が高いと、回答が遠回しになりませんか?
- 不確実な点は保留しますが、できる範囲では具体的な提案を出すバランスを志向しているとAnthropicは説明しています。
Claude CodeのFast modeを使えば、Opusの賢さを保ったまま応答速度を2.5倍にすることもできます。
- Q7. ビジネス利用で気をつけることは?
- 最終的な事実確認と意思決定は人が担う前提を保つことです。
誠実性が高くても誤りはゼロにならないため、重要な判断ほど人のレビューを残す設計が安全です。
- Q8. 料金はどのくらいかかりますか?
- 2026年9月時点の公式価格は、Opus 4.8が通常利用で入力5ドル・出力25ドル(100万トークンあたり)、Fast modeで入力10ドル・出力50ドルです(Anthropic公式発表)。
料金は改定されることがあるため、最新の価格は公式ページで確認するのが確実です。
用語集:この記事のキーワード整理
この記事に登場する主要な用語を、公式情報にもとづいて一覧にまとめました。
| 用語 | 意味 |
|---|---|
| Claude Opus 4.8 | 2026年5月28日公開。Anthropicの上位モデルで、複雑な推論と自律作業に向く。2026年9月時点はレガシー扱い |
| 誠実性(honesty) | 限界や不確実さを申告し、裏付けのない主張やミスリードを避ける態度 |
| エージェント | AIが目標に向け複数の手順を自律的に実行する仕組み |
| ハルシネーション | AIが事実でないことを事実のように述べる現象 |
| Dynamic workflows | Claude Codeで数百のサブエージェントを並列実行できるリサーチプレビュー機能 |
| Effort control | claude.ai・Coworkで応答にかける思考の労力を選べる機能 |
| 知識カットオフ | モデルが学習した情報の締め切り時点。Opus 4.8は2026年1月 |
| Claude Code | Claudeを使う開発・作業支援ツール。CLIやIDE拡張等で利用可 |
| Fast mode | Opusの賢さを保ったまま出力を2.5倍速に高速化する機能 |
| Claude Fable 5.1 / Opus 5.5 | 2026年9月時点の現行最上位モデル群。Opus 4.8の後継にあたる |
まとめ:誠実なAIエージェントは「普通の人」の味方になる
Claude Opus 4.8の価値は、単なる賢さではなく、「限界を申告しながら、自律的に作業をこなす」という組み合わせにあります。
誠実性が高いことで、AIに任せた作業の状態を正確に把握でき、レビュー工数を抑えながら意思決定の質を保てます。
一方で、誤りがゼロになるわけではなく、知識カットオフや運用設計の負荷といった注意点も残ります。
さらに2026年9月時点では、Opus 4.8自体もOpus 5.5・Fable 5.1という後継モデルを持つ「レガシー」の位置づけになっている点も、正直に押さえておくべき事実です。
だからこそ、小さなタスクから試し、確認ポイントを決め、必要に応じて最新モデルとの比較検討もしながら段階的に信頼を確かめていく使い方が現実的です。
専門知識がなくても、AIが「ここは確証がない」と正直に教えてくれることは、これから学ぶ人にとって大きな安全装置になります。
誠実なAIエージェントは、特別な人だけのものではなく、再現性を求める普通の人にこそ役立つ存在だと言えます。
AI×SNSで「普通の人」が成果を出す方法を、無料で体系的に学べます
Claudeのような誠実なAIを味方につけ、発信や副業で再現性のある成果を出すための手順を、無料で学べる特典にまとめました。
今のうちに受け取っておきましょう。
※本記事は2026年5月28日のClaude Opus 4.8公式発表時点の情報をもとに、2026年9月29日時点の公式ドキュメントで最新ラインナップ・価格・仕様を確認して更新しています。
料金・機能・提供状況は変更される場合があるため、最新情報はAnthropic公式発表およびClaude Platform公式ドキュメントでご確認ください。
あなたのInstagramをAIで無料診断
S.Earch(SNS分析AI)が、約30秒であなたのアカウントの弱点と次の一手を可視化します。
7日間完全無料・カード登録不要、その後も自動でフリープランに移行します。
まず1問だけ試したい方は 登録不要でAIに質問
次に読みたい関連記事
このテーマの全体像: Claudeの料金・モデル・始め方まとめ
あわせて読みたい・姉妹メディア