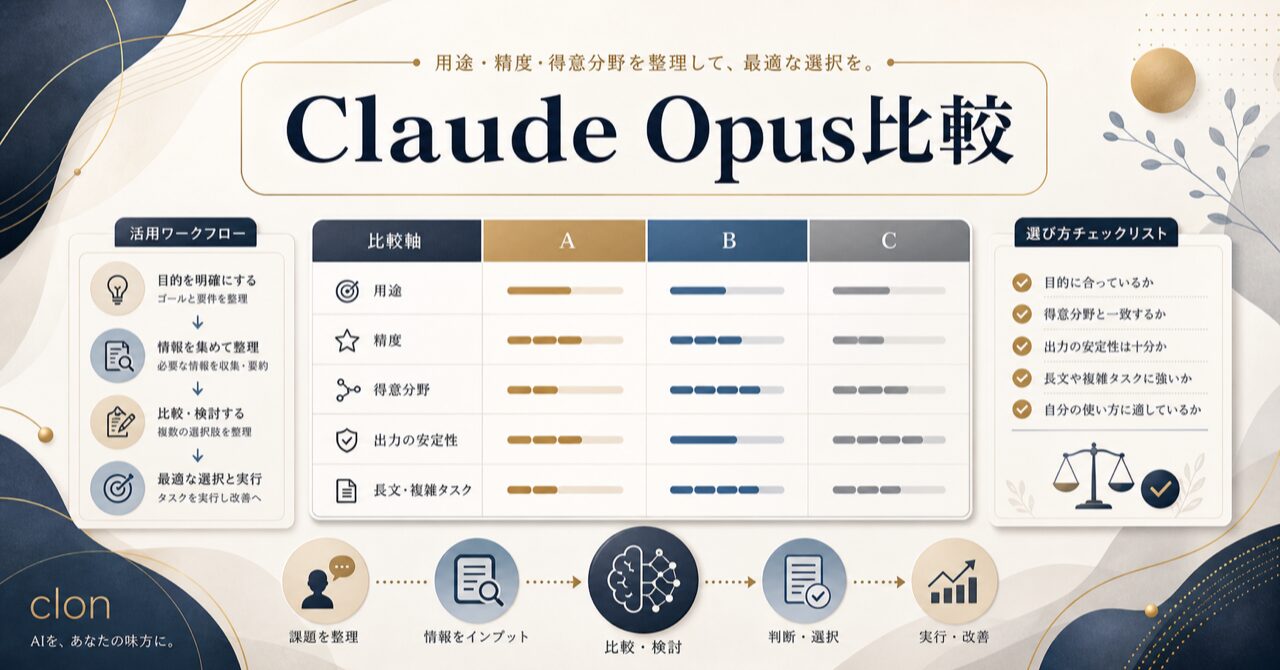
「Claude Opus 4.8 を GPT 系や Gemini 系と比べて選びたい」と調べ始めたときに、最初に確かめたいのは、比べる対象の Opus 4.8 がいまの Claude の中でどこに位置するかです。
Anthropic の公式モデル一覧は、2026年10月10日に確認した時点の現行モデルとして Claude Fable 5.1・Claude Opus 5.5・Claude Sonnet 5.5・Claude Haiku 5.5 を掲載し、迷ったときは Claude Opus 5.5 から始めるよう案内しています。Opus 5.5 の評価で足りない場合の上位の選択肢が Claude Fable 5.1 です。Claude Opus 4.8 はこの現行モデルに含まれない以前のモデルで、この記事では「いまから選ぶ現行モデル」ではなく、比較と移行を考えるときの起点として扱います。
ベンチマークの点数を並べる記事ではありません。公式ページの文言で確認できる範囲に絞り、次のような疑問に答えます。
- Opus 4.8 を使っている、または検討していて、現行の Opus 5.5 とどう向き合えばよいか
- GPT 系・Gemini 系と比べるとき、何を基準に見ればよいか
- 料金は、どのページの、どの条件の表示を読めばよいか
- 日本語の仕事で使うとき、自分の文書でどう確かめればよいか
AIは「使い方を設計できた人」が伸びます。
まずは一つの作業から試してみてください。
この記事でわかること
【完全無料】AI×SNSで成果を出す100大特典を受け取る
AIの使い方を、SNS運用の実務につなげたい方へ。LINEで特典の案内を受け取れます。
- 公式が示す現行の Claude モデルと、Opus 4.8 の現在の位置づけ
- Opus 4.8 を使い続けるか、現行へ切り替えるかの判断の流れ
- Claude の料金を、プランと API に分けて条件つきで読む方法
- GPT 系・Gemini 系の公式ページで確認できる位置づけ
- 用途別に最初に試す候補を決める表と、日本語・長文の確かめ方
- 提供形態とデータの扱いを比べる観点、仮の例による選び方
Claude Opus 4.8 は現行モデルなのか|公式の現行は Claude Opus 5.5
Claude Opus 4.8 は、Anthropic の公式モデル一覧に載る現行モデルではありません。2026年10月10日に確認した時点の現行は Claude Opus 5.5 で、その上位に Claude Fable 5.1 があり、Opus 4.8 は以前のモデルとして扱われています。
公式モデル一覧が示す現行モデル
公式モデル一覧は、現行の Claude を Fable 5.1・Opus 5.5・Sonnet 5.5・Haiku 5.5 の順に並べ、用途の違いを短い文で説明しています。次の表は、その説明を日本語に要約し、API で指定するモデル ID と並べたものです。表の最終行が、この記事の比較の起点である Opus 4.8 です。
| モデル | 公式の位置づけ(要約) | API のモデル ID | 現行モデル一覧での扱い |
|---|---|---|---|
| Claude Fable 5.1 | 高度な推論と長期にわたるエージェント作業向け | claude-fable-5-1 | 掲載あり |
| Claude Opus 5.5 | 長時間のエージェント型コーディングと知識業務向け。迷ったらここから始める案内 | claude-opus-5-5 | 掲載あり |
| Claude Sonnet 5.5 | 速度と知能の組み合わせを重視 | claude-sonnet-5-5 | 掲載あり |
| Claude Haiku 5.5 | 分類・抽出・ルーティングなど、大量で応答の速さが要る処理向け | claude-haiku-5-5 | 掲載あり |
| Claude Opus 4.8 | 現行モデル一覧には説明が無い | claude-opus-4-8 | 掲載なし(以前のモデル) |
同じ公式モデル一覧は、現行モデルがいずれもテキストと画像の入力、テキストの出力、多言語、画像の読み取り(ビジョン)、ツール利用に対応すると説明しています。出力がテキストと記載されている点は、画像を生成したい用途を考えるときに関わってきます。
Opus 4.8 の現在の状態を公式で確かめる
Anthropic のモデル廃止予定表では、claude-opus-4-8 の状態は Active、廃止の時期は2027年5月28日より早くはならない旨(原文は Not sooner than May 28, 2027)が記載されています。いますぐ使えなくなると決まっているわけではありません。ただし、現行モデル一覧から外れているため、新しく選ぶ場合には、Opus 4.8 を選ぶ理由を自分の用途で説明できる状態にしておく必要があります。
Anthropic の料金ページでは、Opus 4.8 は Legacy models(旧モデル)の欄に掲載されています。金額は現行モデルとは別の欄にあるので、見積もりを作るときは、現行の Opus 5.5 の欄と取り違えないようにします。Opus 4.8 の性能の数値やコンテキスト長は、公式の現行モデル表では確認できないため、この記事には書きません。必要な場合は、公式モデル一覧が説明している Models API で、使っているモデル自身の max_input_tokens や max_tokens を取得して確認します。
Opus 4.8 と現行モデルの違いを、記事側の説明に頼らず自分で確認したい場合は、Claude Opus 4.8とは?現行はOpus 5.5|料金・Fable 5.1との違いも参考になります。
現行4モデルの仕様の違い
次の表は、公式モデル一覧の比較欄から、数値や段階が明記されている項目だけを写したものです。Opus 4.8 の値はこの比較欄に無いため、列に含めていません。
| 項目 | Fable 5.1 | Opus 5.5 | Sonnet 5.5 | Haiku 5.5 |
|---|---|---|---|---|
| 応答速度の目安(公式の相対表記) | Slower | Moderate | Fast | Fastest |
| コンテキストウィンドウ | 1M tokens | 1M tokens | 1M tokens | 1M tokens |
| 最大出力 | 128K tokens | 128K tokens | 128K tokens | 128K tokens |
| Thinking(思考)の方式 | Adaptive(常時オン) | Adaptive(常時オン) | Adaptive | Adaptive |
| 既定の effort | high | medium | high | medium |
| 廃止の時期(公式表記) | Not sooner than September 1, 2027 | Not sooner than September 22, 2027 | Not sooner than September 28, 2027 | Not sooner than October 7, 2027 |
応答速度は、公式が「Comparative latency」として相対的に示す段階で、秒数ではありません。速さを重視するなら Sonnet 5.5 や Haiku 5.5、推論の深さや長期の作業を重視するなら Fable 5.1 や Opus 5.5、という大まかな読み方ができます。ただし、どれを選ぶかは自分の依頼で試して決めます。
Opus 4.8 を使い続けるか、Opus 5.5 へ切り替えるか
判断は、①いまの用途で困っていないか、②モデル ID を差し替えられる状態か、③自分の依頼で Opus 5.5 を試して違いが出るか、の順に進めます。以前のモデルにも廃止予定表で示される猶予はありますが、新しく始めるなら、公式が最初の候補に挙げる Opus 5.5 から比べるのが自然です。
切り替えの前に洗い出す場所
モデルの切り替えは、モデル名を一か所書き換えるだけで済むとは限りません。次のような場所に、古いモデル名や前提が残っていないかを先に探します。
- API の呼び出しコードや設定ファイルに書かれたモデル ID(claude-opus-4-8 など)
- 社内の手順書、プロンプト集、テンプレートに書かれた「このモデルでは〜」という注意書き
- 費用の見積もり表や、請求の上限を決めた資料
- モデルごとの出力の癖に合わせて作った、後工程のチェック手順
仮の例:議事録要約を自動化しているチーム
ここからは、実在の事例ではなく、考え方を示すための仮の例です。小さなチームが、会議の文字起こしを API で要約する仕組みを作り、モデル ID に claude-opus-4-8 を指定しているとします。
このチームは、まず代表的な文字起こしをいくつか選びます。短い定例会議、複数の議題が混ざった会議、結論が出なかった会議のように、性格の違うものを入れます。次に、同じ指示文でモデル ID だけを claude-opus-5-5 に変えて両方の要約を出し、決定事項の抜け、担当者の取り違え、口調の揺れを見比べます。あわせて、入力と出力のトークン数を記録し、料金ページの表示と掛け合わせて費用の目安を出します。
仮の結果として、要約の品質に差が見られず、費用の目安もほぼ同じなら、現行モデルへ切り替えても失うものは少ないと判断できます。差が出た場合は、どの種類の会議で差が出たかを記録し、その種類だけ別のモデルを使う運用も選べます。どちらの結果でも、判断の根拠が自分の文書で残ることが大切です。
費用を見積もるときの注意
料金は、モデルの違いだけでなく、入力の長さ、出力の長さ、キャッシュの利用で変わります。実際にどれだけトークンを使っているかは、Claude Code の利用であればClaude Codeの使用量とコストの確認方法|/usageの見方と削減策の手順で確認できます。API の場合も、まず自分の使用量を測ってから、次の章の料金表と照らし合わせます。
Claude の料金は条件つきで読む|プランとAPIの違い
Claude の料金は、チャットなどを使う月額プランと、API をトークン単位で使う従量の料金に分かれます。Anthropic の料金ページで2026年10月10日に確認した表示を、USD・税別の条件つきで整理します。
月額プランの表示
次の金額は、料金ページに表示されているもので、すべて USD・税別です。為替や地域、キャンペーンで実際の支払いが変わる場合があるので、申し込む画面の表示を優先します。プランの違いを選び方から知りたい場合は、Claude料金プラン比較|Free・Pro・Maxの違いと選び方も使えます。
| プラン | 料金の表示(USD・税別) | 読むときの条件 |
|---|---|---|
| Free | $0 | 無料で試せるプラン |
| Pro | 月払い $20/年払い $200 を一括 | 年払いは公式表示の月額換算で $17 |
| Max | 月額 $100 から | 使用量の多い人向けの上位プラン |
| Team 標準席 | 年払い換算で $20/席/月、月払いで $25 | 席の種類で金額が異なる |
| Team Premium 席 | 年払い換算で $100/席/月、月払いで $125 | 標準席より使用量が多い席 |
| Enterprise | 年払い $20/席/月に加え、API 料金での利用料 | 大規模な組織向けで、契約は個別に相談 |
Claude Code は、Pro・Max・Team・Enterprise のプランに含まれると料金ページに記載されています。コーディング用途で比較するなら、単体のモデル料金だけでなく、使っているプランに何が含まれるかも合わせて見ます。
API の標準料金
API の料金は、100万トークン当たりの入力と出力で示されます。次の表は料金ページの API 標準料金です。Haiku 5.5 だけは、プロンプトが10万トークン以下か超えるかで金額が変わります。
| モデル | 入力(100万トークン当たり) | 出力(100万トークン当たり) | 条件 |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | 標準料金 |
| Claude Opus 5.5 | $4 | $20 | 標準料金 |
| Claude Sonnet 5.5 | $2 | $10 | 標準料金 |
| Claude Haiku 5.5 | $0.10 | $0.50 | プロンプトが10万トークン以下の場合 |
| Claude Haiku 5.5 | $0.50 | $2.50 | プロンプトが10万トークンを超える場合 |
Sonnet 5.5 のキャッシュ読み込みについては、公式ページの間に時点の違いがあります。Sonnet 5.5 の発売時の発表には100万トークン当たり $0.20 と書かれていますが、現在の料金ページの表示は $0.10 です。Haiku 5.5 の発表に、Sonnet 5.5 のキャッシュ読み込みを $0.20 から $0.10 へ引き下げたという記載があるため、現行の料金として読むべきは $0.10 です。古い記事や資料に $0.20 とあっても、誤りではなく時点の違いである可能性があります。
Sonnet 5.5 の位置づけと使い分けは、Claude Sonnet 5.5とは|料金・Sonnet 5との違い・使い分けで詳しく扱っています。
主要競合AIの概要――GPT系・Google系・Llama系とは
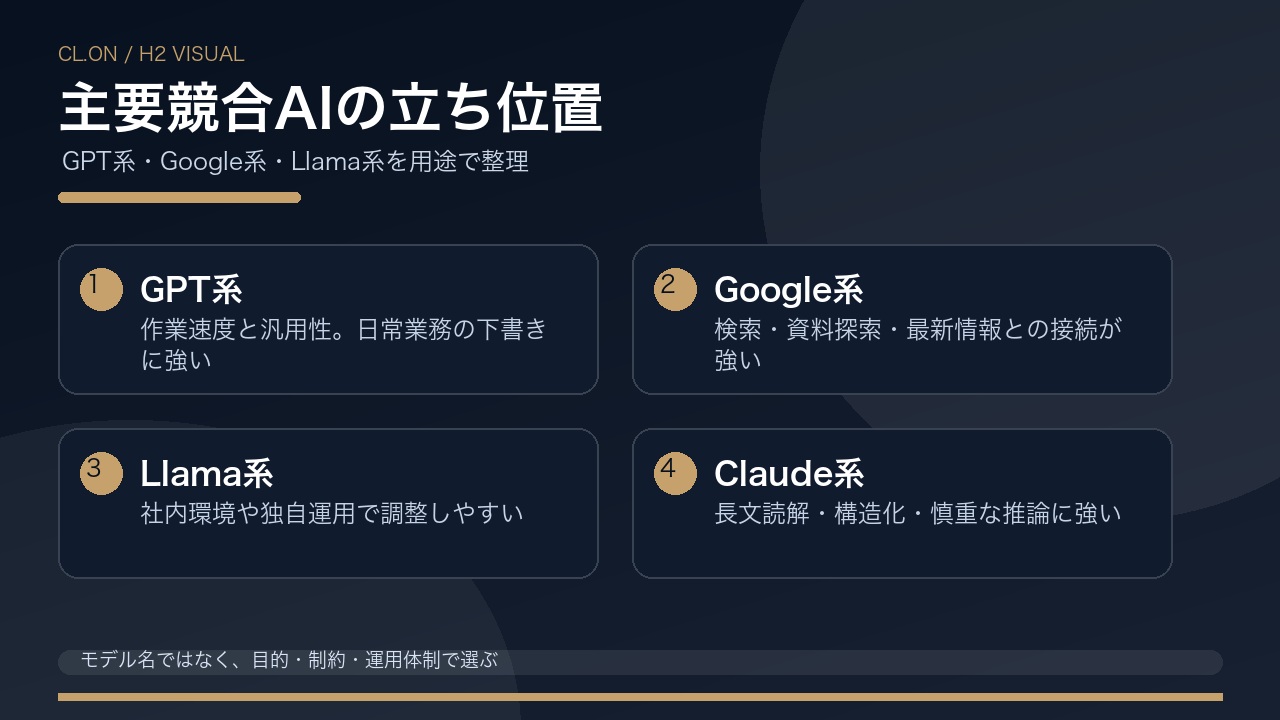
上の図は、GPT 系・Google 系・Llama 系・Claude 系を用途ごとに見るための大まかな見取り図です。各社の公式な評価ではなく、「どの系統から試すか」を考えるきっかけとして使うものです。以下では、公式ページに書かれている説明を、系統ごとに整理します。モデル名は、各社の公式ページで確認できたものに限っています。
GPT 系(OpenAI)の公式な位置づけ
OpenAI のCodex のモデル一覧では、GPT-6 Astra がコード・アプリ・調査にわたる複雑な作業向け、GPT-6.1 Sol が複雑な作業を Astra より低い費用で進めたい場合の候補、GPT-6 Luna が要約・抽出などの焦点を絞った大量処理向けと説明されています。同じページには、GPT-5.5 が前の世代の主力モデルで、2026年10月14日に ChatGPT・ChatGPT Work・Codex から退役し、OpenAI API では引き続き使えるという記載もあります。
API 向けには、GPT-5.6 のガイドがあり、gpt-5.6-sol がフラグシップの能力向け、gpt-5.6-terra が知能と費用のバランス、gpt-5.6-luna が効率的な大量処理向けと整理されています。Codex のモデル一覧は Codex 向けのページなので、通常の ChatGPT での提供状況の根拠としては使わず、利用する窓口ごとに公式ページを確認します。
Google 系(Gemini)の公式な位置づけ
Google のGemini API のモデル一覧では、Gemini 3.8 Flash が長期的なソフトウェア開発・自律エージェント・複雑な企業業務向けの安定版、Gemini 3.1 Pro が複雑な問題解決に対応するプレビュー版、Gemini 3.5 Flash-Lite が大量処理向けに速度と費用効率を重視した安定版と説明されています。Nano Banana 2.1 は画像の生成と編集を担うモデルとして載っています。
モデル一覧は、モデルごとに「Stable」「Preview」といった提供状態を表示しています。業務に組み込む前に、使うモデルの提供状態の表記を公式ページで見直す習慣をつけます。
Llama 系のようなモデルをどう扱うか
図の Llama 系は、社内環境や独自の運用で調整しやすいタイプのモデルの例として置かれています。このタイプは、提供元が定めるライセンス条件やモデルごとの仕様を自分で確認し、動かす環境の構築と保守も自分たちで担う前提になります。この記事では、個別のモデルの性能や料金には触れません。比べたい場合は、提供元の公式ページにある仕様と利用条件を同じ手順で確認します。
| 系統 | 公式ページで確認できる位置づけ | 確認先 |
|---|---|---|
| Claude(Anthropic) | Fable 5.1・Opus 5.5・Sonnet 5.5・Haiku 5.5 を現行として掲載 | Claude のモデル一覧 |
| GPT 系(OpenAI) | GPT-6 Astra・GPT-6.1 Sol・GPT-6 Luna などを用途別に説明 | Codex のモデル一覧 |
| Google 系(Gemini) | Gemini 3.8 Flash・Gemini 3.1 Pro・Gemini 3.5 Flash-Lite などを提供状態つきで掲載 | Gemini API のモデル一覧 |
あなたのInstagramをAIで無料診断
S.Earch(SNS分析AI)が、約30秒であなたのアカウントの弱点と次の一手を可視化します。
7日間完全無料・カード登録不要、その後も自動でフリープランに移行します。
まず1問だけ試したい方は 登録不要でAIに質問
何を基準に選ぶか|5項目で比べる
モデルを選ぶ基準は、用途、料金体系の確認先、提供形態、データの扱い、提供状態の5つです。性能の順位表を探すより、この5項目を各社の公式ページで同じ順番に確認するほうが、比べ方がぶれません。
次の表は、選ぶときに確認する5項目を、Claude・OpenAI・Google の公式ページの確認先とあわせて並べたものです。どの欄も、点数や優劣ではなく、「どこを見ればよいか」を示しています。
| 基準 | 確認する内容 | Claude | OpenAI(GPT 系) | Google(Gemini 系) |
|---|---|---|---|---|
| 用途 | 各モデルの公式な位置づけが、自分の仕事に合うか | モデル一覧の用途説明 | Codex のモデル一覧の用途説明 | Gemini API のモデル一覧の用途説明 |
| 料金体系の確認先 | 月額プランと従量課金のどちらを使うか、通貨・税・適用条件 | 料金ページ | Codex の料金ページ | Gemini API の料金ページ |
| 提供形態 | アプリ、API、クラウド経由のどれで使うか | モデル一覧のプラットフォーム別 ID | 各モデルのページに書かれた提供窓口 | Gemini API のモデルごとの提供状態 |
| データの扱い | 入力内容の学習への利用、保存、管理者機能の条件 | 料金ページのプラン比較にある「Model training」の行 | 使うプランの公式な説明ページ | 使うプランの公式な説明ページ |
| 提供状態 | 現行か、以前のモデルか、プレビューか、退役予定があるか | 廃止予定表 | Codex のモデル一覧に書かれた退役の案内 | モデル一覧の「Stable」「Preview」の表記 |
データの扱いの行は、モデルの名前ではなく、使うプランや契約で条件が変わる点に気をつけます。個人向けのプランと、チームや API の契約では、同じ会社でも表示が分かれている場合があります。具体的には、後の章で観点を整理します。
用途別に最初に試す候補を決める
用途別の候補は、各社の公式ページが示す位置づけをもとに「最初に試す順」を決めるためのもので、優劣の順位ではありません。自分の依頼を数本用意し、候補同士を同じ条件で試したうえで、最終的に選びます。
| 用途 | Claude | OpenAI(GPT 系) | Google(Gemini 系) |
|---|---|---|---|
| 複雑な推論・問題解決や、長期にわたる自律的な作業 | Claude Fable 5.1 | GPT-6 Astra | Gemini 3.1 Pro(プレビュー版) |
| 長時間のコーディング・知識業務 | Claude Opus 5.5 | GPT-6.1 Sol | Gemini 3.8 Flash(安定版) |
| バランス重視(何と何のバランスかは各社の説明で異なる) | Claude Sonnet 5.5 | gpt-5.6-terra | 公式の説明で近い位置づけのモデルを確認する |
| 大量で応答の速さが要る処理(分類・抽出・要約) | Claude Haiku 5.5 | GPT-6 Luna | Gemini 3.5 Flash-Lite(安定版) |
| 画像の生成・編集 | 現行モデルの出力はテキスト(画像は入力として読める) | 今回確認した公式ページには該当モデルの記載なし | Nano Banana 2.1 |
この表は、Claude の欄を公式のモデル一覧、GPT 系の欄をCodex のモデル一覧とGPT-5.6 のガイド、Gemini 系の欄をGemini API のモデル一覧から作っています。バランス重視の行は、Claude の Sonnet 5.5 が速度と知能の組み合わせ、gpt-5.6-terra が知能と費用のバランスと、公式の説明が指す内容が異なります。同じ行にあっても、同じ性格のモデルとは限りません。また、「確認する」と書いた欄は、公式ページで同じ位置づけの説明を確認できていないという意味で、そのモデルが無いと断定するものではありません。
ChatGPT との違いを、モデル単体ではなく使い方の面から知りたい場合は、ClaudeとChatGPTの違いと使い分けをまとめた記事が参考になります。
日本語対応力の比較
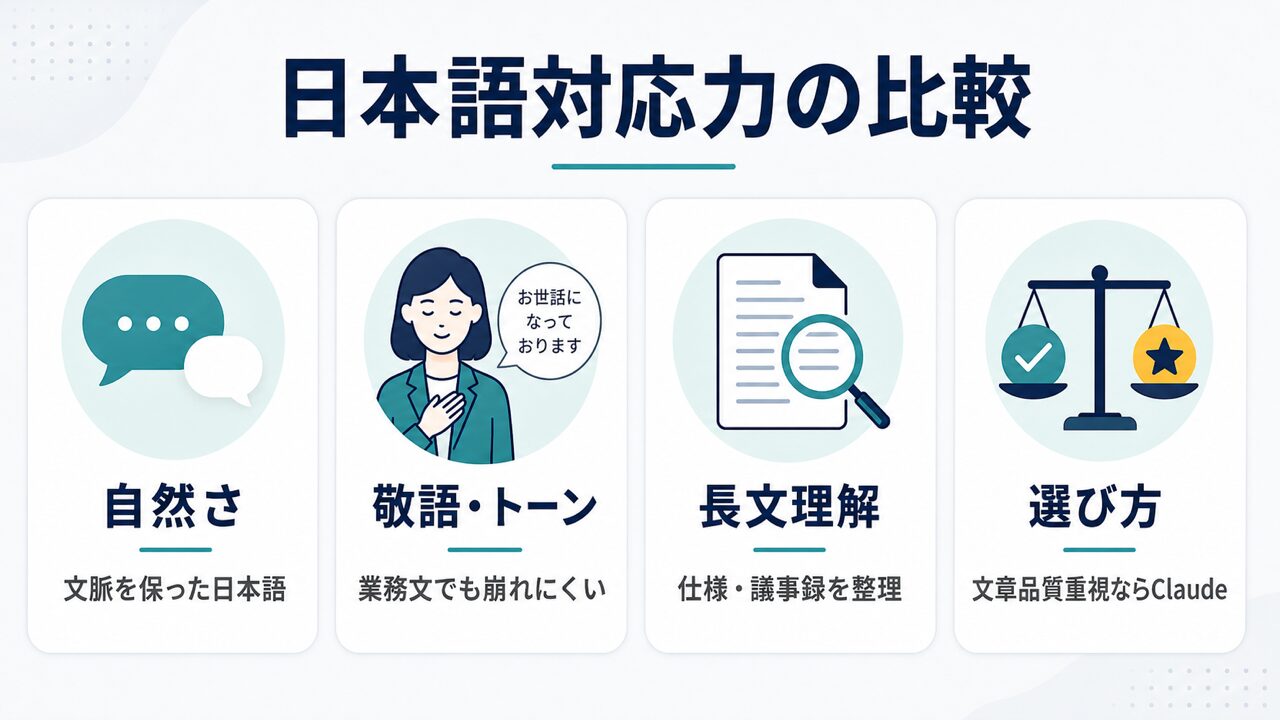
図は、日本語の仕事で見たい観点として、自然さ、敬語・トーン、長文理解、選び方の四つを挙げています。図の「選び方」の欄は、文章の質を重視する場合の出発点として Claude を挙げていますが、この記事では優劣を断定せず、自分の文書で確かめる手順を示します。
公式ページの記載で確認できること
Anthropic のモデル一覧は、現行の Claude モデルが多言語に対応すると記載しています。ただし、これは「多言語に対応する」という確認であり、日本語の文章の質を他のモデルと比べた結果ではありません。GPT 系・Gemini 系についても、日本語の質を各社が数値で一律に示しているとは限らないため、公式ページの記載と実際の出力は分けて考えます。
自分の文書で試す評価シート
日本語の質は、依頼の種類で見え方が変わります。次の表は、仮の例として、業務でよくある依頼を用意し、同じ指示文を各モデルに渡して見比べるための評価シートです。採点は自分たちの基準で付け、点数をそのまま他社の評価として公開しないようにします。
| 観点 | 見るところ | 試す依頼の例(仮の例) |
|---|---|---|
| 自然さ | 文脈に沿った言い回しか、直訳調や不自然な繰り返しが無いか | 商品紹介文を、読者向けに書き直してもらう |
| 敬語・トーン | 相手との関係に合った敬語が、文章全体で一貫しているか | 取引先への依頼メールを、丁寧だが簡潔に書いてもらう |
| 長文理解 | 長い資料の要点と、離れた箇所の関係を取り違えずに整理できるか | 社内手順書を渡し、例外条件だけを抜き出してもらう |
| 指示への忠実さ | 文字数、見出し、禁止事項などの条件を守っているか | 条件を5つ並べた指示で、短い案内文を作ってもらう |
評価するときは、モデルの名前を伏せたまま出力を並べ、複数人で読むとぶれが減ります。結果は、同じ依頼を日を変えて試して確認します。1回の出力だけで決めないのが、日本語の質を比べるときの基本です。
長文処理とコンテキストの確認点
長文を扱うときは、入力できる量(コンテキストウィンドウ)と、出力できる量(最大出力)を分けて確認します。Claude の現行4モデルは、公式モデル一覧でコンテキストウィンドウが 1M tokens、最大出力が 128K tokens と記載されています。
数字が大きいほど常に有利、というわけではありません。入力が長くなるほどトークンの消費量も増え、料金や応答時間に響きます。また、日本語の文字数とトークン数は一致しないため、実際の文書でどれだけ消費するかを一度測っておくと、見積もりのずれを減らせます。
GPT 系・Gemini 系のコンテキスト長は、モデルごとに異なります。OpenAI のモデルのページとGoogle のモデルのページで、使うモデル自身の記載を確認し、この記事では数値を書き写しません。
仮の例:離れた箇所の関係を確かめる
長文の理解は、仕様書のような文書で試すとわかりやすくなります。仮の例として、社内の運用ルールを書いた長めの文書を用意し、冒頭に基本ルール、中盤に例外、末尾に更新履歴を置きます。そのうえで、「中盤の例外が、冒頭のルールのどれに当たるか」を質問します。冒頭と中盤の両方を踏まえて答えられているかを見れば、長い入力の後半を読めているかを確かめられます。
この確認は、同じ文書を各モデルに渡し、答えの根拠として引用している箇所が合っているかまで見ます。答えが正しそうに見えても、根拠の箇所を取り違えていることがあるためです。
提供形態の違い|アプリ・API・クラウド・Claude Code
同じモデルでも、アプリで使うか、API で使うか、クラウド経由で使うかで、指定する ID や契約の形が変わります。Claude は、公式モデル一覧に、プラットフォームごとのモデル ID がまとめられています。
| 提供経路 | Claude Opus 5.5 の ID | Claude Sonnet 5.5 の ID |
|---|---|---|
| Claude API | claude-opus-5-5 | claude-sonnet-5-5 |
| Amazon Bedrock | anthropic.claude-opus-5-5 | anthropic.claude-sonnet-5-5 |
| Google Cloud | claude-opus-5-5 | claude-sonnet-5-5 |
| Microsoft Foundry | claude-opus-5-5 | claude-sonnet-5-5 |
| Claude Platform on AWS | claude-opus-5-5 | claude-sonnet-5-5 |
モデル一覧には、各モデルのページに、提供しているプラットフォームが書かれているとも説明されています。使いたい経路で目的のモデルが提供されているかは、ID だけで判断せず、モデルごとのページで確かめます。
アプリ側では、Anthropic が2026年9月16日付の公式記事で、Claude Cowork とチャットを一つの Claude に統合し始めたと説明しています。アプリの画面や機能の構成は変わる可能性があるため、社内向けの手順書には、確認した日付を添えて残すと後から見直しやすくなります。
コーディングの用途では、料金ページの記載のとおり、Claude Code が Pro・Max・Team・Enterprise のプランに含まれます。Claude Code の基本はClaude Codeのインストールと基本機能をまとめた記事から確認できます。
データの扱いと安全性を比べる観点
データの扱いを比べるときは、モデルの名前ではなく、使うプランや契約ごとの条件を読みます。入力した内容が学習に使われるか、どの程度保存されるか、管理者が何を制御できるかを、各社の公式な説明で確認します。
Claude の料金ページのプラン比較には「Model training」の行があり、プランごとに表示が分かれています。申し込む前に、使うプランの列を読み、設定で変えられる項目があるかを確認します。GPT 系・Gemini 系も、同じように、使うプランや API の契約の説明ページで条件を確認します。
社内で使う場合は、次の観点を整理してから選ぶと、後から手戻りが起きにくくなります。
- 入力してよい情報の範囲を、社内規程で先に決めておく
- 個人向けのアカウントと、組織の契約を使い分けるルールを決める
- 管理者が利用状況を把握できる仕組みが必要かを確認する
- 出力を人が確認する工程を、業務の流れに組み込む
安全性の考え方は各社で説明の仕方が異なり、どれが優れているかを一言で断定できるものではありません。自社の要件に照らして、公式な説明をどこまで確認できたかを記録しておくことが、監査や社内説明の場面で役立ちます。
仮の例で選ぶ手順|小さなチームの3業務
選び方の手順は、業務を分け、重視することを決め、候補を絞って試し、結果を記録する流れです。次の仮の例では、議事録要約・取引先への返信案・手順書の下書きの3業務を、モデルごとに振り分けて考えます。
これは実在の事例ではなく、考え方を示すための仮の例です。結果の数値は書いておらず、結論も仮のものです。
| 業務 | 重視すること | 最初に試す候補(仮) | 確認すること |
|---|---|---|---|
| 議事録の要約 | 決定事項と担当者の取りこぼしが無いこと、処理の費用 | Claude Sonnet 5.5 と Claude Opus 5.5 | 代表的な議事録で、抜けと取り違えを見比べる |
| 取引先への返信案 | 敬語の一貫性、短く伝わること | Claude Sonnet 5.5 と、使い慣れている他社のモデル | 評価シートで、トーンと簡潔さを複数人で読む |
| 社内手順書の下書き | 例外条件の整理、長い資料の扱い | Claude Opus 5.5 | 離れた箇所の関係を取り違えないかを、質問で試す |
仮の結果として、議事録と返信案は Sonnet 5.5 で十分に用が足り、手順書の下書きだけ Opus 5.5 を使う、という分担になったとします。この場合、同じ Claude の中でも用途ごとにモデルを使い分けるほうが、費用と品質の両面で納得しやすくなります。
逆に、返信案の評価で他社のモデルのほうがチームの好みに合うなら、その業務だけ他社のモデルを使う選び方もあります。大切なのは、モデルを一つに決めることではなく、業務ごとに根拠のある選び方を残すことです。
実タスクで評価するときの進め方
評価は、業務で実際に使う依頼を数本用意し、同じ指示文を候補すべてに渡して始めます。出力は、先に決めた観点で記録し、気づいた癖と、指示文を変えたときの変化も残します。ベンチマークは参考情報として読みつつ、自社の文体や業界用語に合うかは、自分の依頼でしか確かめられません。
指示文の書き方で結果が大きく変わることもあります。比較の前に、Claudeへの指示の書き方をまとめた記事で、指示文を整えておくと、モデルの差と指示文の差を切り分けやすくなります。
よくある質問(FAQ)
- Q1. Claude Opus 4.8 は、いまも使えますか?
- Anthropic のモデル廃止予定表では、claude-opus-4-8 は Active と記載され、廃止は2027年5月28日より早くならない旨が書かれています。ただし現行モデル一覧には含まれないため、新しく始めるなら Opus 5.5 などの現行モデルから比べます。
- Q2. Opus 4.8 と Opus 5.5 の違いを、数値で教えてもらえますか?
- この記事は、公式ページで確認できない数値を載せない方針です。Opus 5.5 の仕様は公式モデル一覧で確認でき、Opus 4.8 の値は同じ表に無いため、自分の依頼で両方を試して違いを確かめる方法が有効です。
- Q3. Claude と GPT 系・Gemini 系では、どれが優れていますか?
- 優劣は用途と条件で変わるため、一つに断定しません。公式ページが示す位置づけで候補を決め、自分の依頼で同じ条件のもとに試す方法を、前半の表で整理しています。
- Q4. Claude の料金は、どこで確認すればよいですか?
- 月額プランも API の標準料金も、Anthropic の料金ページに掲載されています。USD・税別の表示か、プランや入力の長さといった適用条件は何かを、金額と一緒に読んでください。
- Q5. Sonnet 5.5 のキャッシュ読み込み料金は、$0.20 と $0.10 のどちらですか?
- 発売時の発表には $0.20、現在の料金ページには $0.10 とあります。Haiku 5.5 の発表に値下げの記載があるため、時点の違いによる食い違いと読み、現行は $0.10 として扱います。
- Q6. 日本語の品質は、どう比べればよいですか?
- 公式ページは多言語対応を確認する材料にはなりますが、文章の質の優劣までは示しません。業務で使う依頼を用意し、モデル名を伏せて複数人で読み比べる方法が、実務に近い比較になります。
- Q7. Fable 5.1 が必要になるのは、どんなときですか?
- 公式モデル一覧は、高度な推論や長期のエージェント作業が必要な場合、または Opus 5.5 を高い effort で評価しても足りない場合に、Fable 5.1 を使うよう案内しています。まず Opus 5.5 で試し、足りなかった点が明確になってから検討します。
用語集
この記事で使う用語を、料金やモデル選びの文脈に絞って整理します。用語の意味を揃えておくと、各社の公式ページの表記を読み比べるときに迷いにくくなります。
| 用語 | 意味 |
|---|---|
| LLM(大規模言語モデル) | 大量のテキストで学習した、文章の理解と生成を行うモデルの総称 |
| コンテキストウィンドウ | モデルが一度に入力として扱える量の上限。トークンで表す |
| 最大出力 | モデルが一度の応答で出力できる量の上限。入力の上限とは別に示される |
| トークン | モデルが文章を処理する単位。文字数とは一致せず、料金の計算にも使われる |
| モデル ID | API でモデルを指定するときに書く文字列。提供経路によって表記が異なる場合がある |
| 以前のモデル(Legacy) | 現行の一覧から外れたが、一定期間は提供が続くことがあるモデル |
| キャッシュ読み込み | 以前に処理した入力を再利用して読み込むときの料金区分 |
| マルチモーダル | テキストに加えて、画像や音声など複数の形式を扱えること |
| エージェント | ツールを呼び出しながら、複数の手順を自律的に進める使い方や仕組み |
| オープンウェイト | 学習済みの重みが公開され、自分たちの環境で動かせる形で提供されるモデルのタイプ |
まとめ
Claude Opus 4.8 は、公式モデル一覧が示す現行モデルには含まれない以前のモデルです。2026年10月10日に確認した現行は Claude Opus 5.5 で、上位の選択肢に Claude Fable 5.1 があります。Opus 4.8 を競合モデルと比べる場合は、Opus 5.5 を含む現行モデルを基準に置き直してから、用途に合う候補を絞り込むのが現実的です。
比較の基準は、用途、料金体系の確認先、提供形態、データの扱い、提供状態の5つです。料金は、USD・税別などの条件と、プランや入力の長さといった適用条件を添えて読み、日本語や長文の質は、自分の依頼で試して確かめます。他社のモデルについても、公式ページに書かれた位置づけだけで候補を決め、優劣は断定しません。
最初の一歩としては、Opus 5.5 と、いま使っているモデルに同じ依頼を渡して見比べるところから始めてください。
AI×SNSで「普通の人」が成果を出す方法を、無料で体系的に学べます
AIツールを使いこなして情報発信を加速させたい方に、実践で培ったノウハウを惜しみなく公開しています。
まずは無料で手に入れてください。
※料金・提供状態・仕様は各社の更新で変わります。申し込みや導入の前に、本文中の公式リンクで最新の表示を確認してください。
関連記事|モデル選びの次に読みたい記事
このテーマの全体像: Claude活用の始め方と全体像
あわせて読みたい・姉妹メディア