Anthropicの公式ケーススタディによると、カナダ・アルバータ州のMinistry of Technology and Innovation(技術・イノベーション省)の内部チームは、Claude Codeを使って4億6,600万行(466 million lines)のコードを20時間でスキャンしました。同じ規模のレビューを従来の方法で行うと約6.5年かかる、というのがチーム自身の見積もりとして紹介されています。
ただし、この数字は「スキャンに要した時間」であり、見つかった問題の件数や修正の完了までを表すものではありません。本記事では、発表で確認できる数値・主体・工程を原文に沿って整理し、行政機関や企業、個人開発者が自分の組織で検討するときの判断材料に落とし込みます。後半では、編集部が作った架空の請求書機能を使い、指摘票・修正案・テスト条件・依頼文の書き方を具体例で示します。
- 発表元と、取り組みの主体はそれぞれ誰か?
- 4億6,600万行・20時間・約6.5年は、何を表す数字か?
- スキャン、指摘、修正、承認は、どんな順序で行われたのか?
- 自組織で試すとき、何を決めてから始めればよいか?
岡田颯太
AIは、使う目的と確認手順を設計してこそ力を発揮します。
まずは対象範囲を小さく決め、一つの作業から検証してみてください。
この記事でわかること
【完全無料】AI×SNSで成果を出す100大特典を受け取る
AIの使い方を、SNS運用の実務につなげたい方へ。LINEで特典の案内を受け取れます。
- アルバータ州政府×Claude Code:事例の全体像
- 4.66億行と20時間という数値の読み方
- スキャンから修正までの流れ:公式が説明している工程
- 発表に出てくる数値の一覧と読むときの注意
- 発表元・導入組織・この記事の架空例の区別
- Claude Codeを使うメリット——具体的な価値
- 導入前に押さえる限界とリスク
- 自組織で検討するための判断表
- 架空の請求書機能で示す指摘票と修正案
- 行政・企業・個人開発者が検討を進める順序
- 利用開始前に準備すること(レビュー依頼文の完成例)
アルバータ州政府×Claude Code:事例の全体像
アルバータ州政府の事例とは、同州のMinistry of Technology and Innovationが、Claude Codeを使って政府システムのコードを調べ、セキュリティ上の問題の発見と修正を進めたと、2026年7月6日にAnthropicが公開したケーススタディで紹介された取り組みです。
発表の概要と時系列
公式ケーススタディは、2026年7月6日付の事例紹介です。同省の内部チームが、省のエンジニアと連携しながら、Claude Codeを通じてClaudeのOpusおよびSonnetのモデルを使い、政府システムの確認・脆弱性の発見・修正に取り組んだと説明されています。本記事の事実関係は、この公式ページの記述に基づいています。
対象となったシステムの規模
同じ公式ページによれば、同省は州の27の省庁すべてのシステムを保守しており、その対象には社会福祉、公共の安全、山火事対応などの分野が含まれます。保守しているのはおよそ1,280のアプリケーションと約3,400のコードリポジトリで、古い・安全でないコードや未対応の不具合、古いソフトウェアといった技術的負債は、数十億ドル規模と見積もられていると紹介されています。
つまり、このスキャンは小さな実験ではなく、州全体の行政システムを対象にした大規模な棚卸しとして語られています。一方で、公式ケーススタディは導入組織の事例であり、他の組織で同じ規模・同じ結果が得られると約束するものではありません。
4.66億行と20時間という数値の読み方
「4億6,600万行を20時間」とは、Anthropicの公式ケーススタディが報告した、コードをスキャンする工程の規模と所要時間です。指摘の正しさ、検出した問題の件数、修正やテストの完了までを含む時間ではありません。
20時間と約6.5年は何を比べているか
公式ページでは、約6.5年という見積もりは「その種のレビューを従来の方法で行った場合にかかったかもしれない時間」として、チーム自身の推定で書かれています。実際に人手で測った結果ではなく、第三者が検証した比較でもありません。この組み合わせを読むときは、次の3点を分けておくと誤読を避けられます。
- 20時間:実際に行ったスキャンの所要時間(公式の報告)
- 約6.5年:従来方式なら要したと同チームが見積もった時間(推定)
- 両者の差:作業の進め方が違うことの表れであり、自組織の所要時間を示す換算式ではない
「スキャン完了」に含まれないもの
スキャンで出た指摘を確認し、修正案を作り、テストして、承認を得るまでの工程は別にあります。公式ケーススタディは、パッチが出荷される前にチームのレビューと承認を経たと説明しており、スキャンの20時間がそのまま全工程の時間になるわけではありません。人間の確認を含む後工程にかかる時間は、対象の複雑さや体制で変わります。
したがって、手元のコードベースの行数に20時間の比率を当てはめて「何時間で終わる」と計算することはできません。コードの言語、確認する項目、既存テストの有無、担当者の人数で、必要な時間は大きく変わるためです。
スキャンから修正までの流れ:公式が説明している工程
公式ケーススタディが説明する流れは、ルールエンジンで既知のパターンを拾い、Claude Codeが各指摘を確認して根拠となるファイルと行を示し、修正案とテストを作って、チームが承認するという順序です。
第1段階:ルールエンジンとClaudeによる二段のスキャン
公式ページによると、スキャンは二つの段階で行われました。最初にルールエンジンが既知のパターンに当てはまる箇所を拾い、次にClaude Codeがその指摘を一件ずつ確認して、該当するファイルと行を引用します。開発者が自分で確かめられる形で結果が出る点が、運用上の要点です。同ページでは、約50のエージェントが並列で自律的に動き、同省が所有する全リポジトリを対象にしたと説明されています。
第2段階:パッチの生成・テスト・再構築
公式ケーススタディでは、Claudeがパッチを作成してテストし、テストが存在しない箇所ではテストも書いたと説明されています。場合によっては、古いシステムをより新しい言語で作り直したとも書かれています。出荷の前には、チームがレビューして承認した点も明記されています。
継続的な確認:レッドチームとブルーチームのエージェント
同ページによれば、Claude Agent SDKで作った専用のエージェントが、攻撃者の視点で調べる「レッドチーム」と、国際的なセキュリティ標準に照らして防御を評価する「ブルーチーム」の役割を担います。アプリケーションごとに、1回の確認でおよそ95のセキュリティ統制が点検され、ブルーチームは修正の計画も書くと紹介されています。
| 工程 | 公式ページの説明 | 読むときの注意 |
|---|---|---|
| スキャン | ルールエンジンが既知パターンを拾い、Claudeが各指摘を確認してファイルと行を示す | 指摘の一覧であり、修正の完了ではない |
| 修正 | パッチの作成とテスト、テストが無い箇所ではテストの作成 | 作成と実行と結果の確認は別の段階 |
| 承認 | 出荷前にチームがレビューして承認 | 最終判断は人間が担う設計 |
| 継続確認 | レッドチーム・ブルーチームのエージェントが約95の統制を点検 | 点検する統制の中身は自組織の基準で決める |
発表に出てくる数値の一覧と読むときの注意
この一覧は、Anthropicの公式ケーススタディに出てくる数値を、「実績」「推定」「計画」に分けて整理したものです。種類が違う数字を同じ重さで読まないための表です。
| 数値 | 公式が書いている内容 | 種類 | 読むときの注意 |
|---|---|---|---|
| 4億6,600万行・20時間 | 同省のチームがコードをスキャンした規模とかかった時間 | 報告された実績 | 指摘件数・修正件数は含まない |
| 約6.5年 | 従来方式で同様のレビューをした場合にかかりうる時間 | チームの見積もり | 実測ではない |
| 約50エージェント | 並列で自律的に動いた数 | 報告された実績 | 自組織で必要な数を示すものではない |
| 約1,280アプリ・約3,400リポジトリ | 同省が保守する対象 | 前提となる規模 | スキャン対象の全数と同じとは書かれていない |
| 約95の統制 | 1回の確認で各アプリを点検する項目数 | 運用の設定 | 項目の中身は自組織の基準で決める |
| 最短4〜5日 | システムによっては、この程度の期間で再構築できる(公式ページ) | 報告された実績の範囲 | 「最短」であり、全システムに当てはまる日数ではない |
| 185→16アプリ | ある省の185のレガシーアプリを、16の再利用できるアプリへ統合する構想(公式ページ) | 計画 | 実行済みの成果としては書かれていない |
再構築の例として、公式ページは約25年前にJavaで手作りされた補助金プログラムのポータルを挙げ、当初の構築に5か月かかったと説明しています。この対比は「作り直しにかかる期間が短くなりうる」ことを示す事例ですが、同じ短縮が他のシステムで再現されるとは述べられていません。
発表元と導入組織を区別して読む
この事例の発表元はClaudeを提供するAnthropicで、取り組みの主体はアルバータ州のMinistry of Technology and Innovationです。主語を取り違えると、提供企業が紹介した導入事例が、政府による独立した評価のように読めてしまいます。
Anthropicは発表元、州の省は取り組みの主体
冒頭で挙げた公式ケーススタディの発表元はAnthropicです。一方、紹介されている取り組みの主体はアルバータ州のMinistry of Technology and Innovationです。引用するときに主語を省くと、「政府が公表した独立評価」なのか「提供企業が紹介した導入事例」なのかが曖昧になります。
したがって、この記事では「Anthropicの公式ケーススタディによると、同省は……」と出典と主体を併記します。「カナダ政府がAIの性能を認定した」「自治体での効果が実証された」といった、発表の範囲を超える言い換えはしません。国全体と一つの州の取り組みも区別します。
後半のコード例は州政府の実装ではない
後半に出てくるinvoice_service、利用者A・B、請求書の所有者チェックは、この記事の説明用に作った架空例です。公式事例から取得したコードや政府システムで検出された問題ではありません。事例を紹介する段落と架空例の段落を分けることで、実際の発表内容と、読者が試すための教材を区別できます。
Claude Codeを使うメリット——具体的な価値
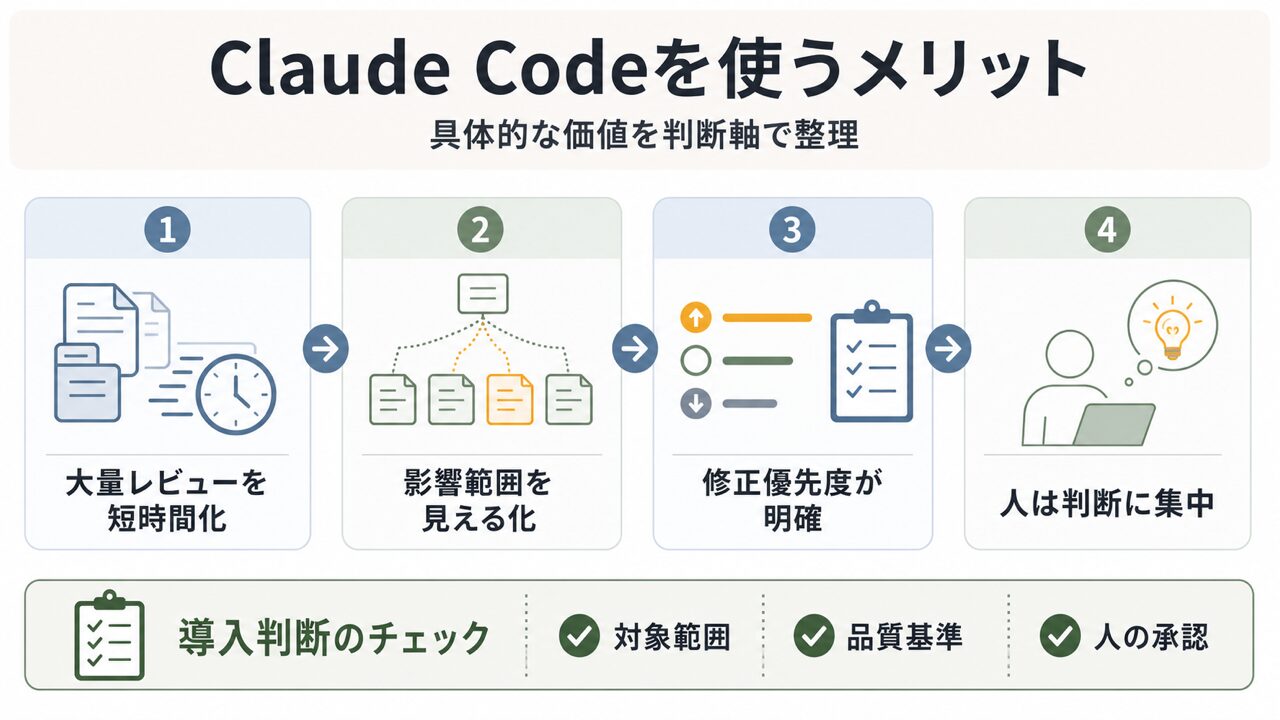
Claude Codeを使うメリットとは、この事例では、コードの読み取り・指摘の根拠提示・パッチとテストの作成を、人のレビューを前提に並列で進められる点として紹介されています。
以下は公式ページに書かれた工程のうち、検討する側にとって価値が見えやすいものを取り上げたものです。いずれも導入組織の報告であり、手元で同じ効果が出ることの保証ではありません。
指摘にファイルと行が付く
公式ページは、Claude Codeが各指摘について該当するファイルと行を引用するとしています。指摘が検証できる形で出るため、開発者は「本当にそのコードがあるか」を自分で開いて確かめられます。AIの説明文が整っているかではなく、引用された箇所が実在し、仕様と食い違っているかで判断できる点が、レビュー補助としての使いやすさにつながります。
テストが無い箇所にもテストを足せる
同ページによると、Claudeはパッチを作るだけでなく、テストが無い箇所ではテストも書いたと説明されています。古いシステムでは、修正が既存の動作を壊さないかを確かめる手段そのものが不足していることがあります。修正案とテストを同時に用意できると、レビュー担当者は差分と検証条件を並べて判断できます。ただし、テストを書くことと実行して通ることは別の段階です。
並列実行で全体の棚卸しを現実的にする
約50のエージェントを並列で動かしたという説明は、人手では一つずつ開けない数のリポジトリを、同じ手順で一通り見るための設計として読めます。ここで価値になるのは、速さそのものより「すべてのリポジトリを同じ手順で一度は確認した」と言える状態を作れることです。その結果をどう仕分けるかは、各組織の担当者が決めます。
古いシステムの作り直しを検討できる
公式ページは、場合によって古いシステムを新しい言語で作り直した例や、ある省の185のレガシーアプリを16の再利用可能なアプリへ統合する計画に触れています。脆弱性の修正にとどまらず、保守しづらい資産そのものを見直す入口としても使われている点は、行政機関に限らず、古い社内システムを抱える企業にも検討材料になります。
導入前に押さえる限界とリスク
限界とリスクとは、AIが出力した指摘や修正案をそのまま採用できない理由のことです。大規模なスキャンの結果ほど、確認の仕組みと責任者を先に決めておく必要があります。
1. 誤った指摘や修正案が混じる
LLMベースのツール全般に共通する課題として、存在しないコードや関数を「あるもの」として説明したり、実際には機能しない修正提案を自信を持って提示したりすることがあります。Claude Codeも例外ではなく、AIの出力を無批判に採用することは危険です。公式ページが、指摘にファイルと行を付けて検証できるようにし、出荷前にチームが承認したと説明しているのも、この前提に沿った設計だと読めます。
2. 見る範囲によって見落としが出る
超大規模なコードベースを単一の文脈で扱えるとは限りません。確認単位の分け方によっては、ファイル間の依存関係や別の層にある認可処理を見落とす可能性があります。対象範囲と確認方法を先に設計し、「見つからなかった」という結果には検索した範囲を添えて記録します。
3. 費用と利用条件は事例から読み取れない
公式ケーススタディ本文には、この取り組みの費用額や、検出した脆弱性の件数・修正した件数は書かれていませんでした。料金や利用条件は提供形態、処理量、契約条件で変わるため、導入前に現行の公式情報と自組織の利用上限を確認してください。
4. データの取り扱いは別に確認する
コードをAIサービスで扱うときは、機密性、送信範囲、権限、ログ、契約条件を組織の規程と利用時点の公式情報に照らして確認します。アルバータ州政府の具体的なデータ処理方法は、このケーススタディだけでは判断できません。特に行政機関や個人情報を扱うシステムでは、スキャンの対象に何を含めるかを、調達や情報管理の部門とあらかじめ詰めておく必要があります。
5. 人の判断力を維持する
AIの出力に依存しすぎないよう、担当者がコードを確認する工程を残します。最終判断と検証は担当者が行い、未確認の指摘をそのまま採用しない運用にします。基礎的なエンジニアリング能力の維持も、引き続き必要です。
自組織で検討するための判断表
判断表とは、公式事例で分かることと、自組織で決めなければならないことを一行ずつ対応させ、導入検討の抜けを見つけるための整理です。事例の規模を、そのまま自組織の見込みに置き換えないために使います。
| 検討する問い | 公式事例で分かること | 自組織で決めること |
|---|---|---|
| どこまでを対象にするか | 同省は所有する全リポジトリを対象にした | 最初は小さなリポジトリ一つから始めるか、重要度の高い系統から始めるか |
| 指摘をどう検証するか | 各指摘にファイルと行を付けて開発者が確かめられるようにした | 誰が、どの基準で採用・不要・保留に仕分けるか |
| 修正をどこまで任せるか | パッチの作成とテストはClaudeが担い、出荷前にチームが承認した | 差分の作成だけを任せるか、変更の適用まで任せるか。承認者は誰か |
| 何をもって成果とするか | スキャン規模と時間、再構築の期間などが報告されている | 採用した指摘の数、差し戻しの数、レビューに要した時間など、自分で測る指標 |
| どのデータを渡してよいか | データ処理の詳細は、この事例だけでは分からない | 認証情報・個人情報・機密コードの扱いを、規程と契約条件で決める |
| 作り直しまで検討するか | 最短4〜5日の再構築例と、統合の計画が紹介されている | 対象システムの仕様書やテストの有無、運用中の影響範囲 |
この表で空欄になる行が多いほど、導入の前に決めることが残っています。表の右列は、スキャンを始める前に埋めておくと、後から「何を確かめたのか」が追いやすくなります。
架空の請求書機能で示す指摘票と修正案
指摘票とは、コードで観察した事実、まだ分からない点、確認先、修正案、採否を分けて書いた記録です。AIが出した指摘を「危険という評価」と「実際に読んだコード」に分けて残すために使います。
以下はこの記事のために作った架空のコードレビュー例です。アルバータ州政府のコード、検出結果、運用手順ではありません。請求書を取得する小さな機能を題材に、指摘から修正判断までの内容を具体化します。
請求書の所有者チェックが抜けている例
想定する仕様は「ログインした利用者は自分の請求書だけを閲覧できる」です。次の疑似コードは、請求書のIDだけでデータを探して返しています。引数に利用者IDがあるのに、返却前の条件に使っていない点がレビューの対象です。
getInvoice(invoiceId, requesterId):
    invoice = findInvoice(invoiceId)
    return invoice
この断片だけで本番環境に脆弱性があるとは断定できません。呼び出し元が所有者を確認している可能性もあるためです。一方、「どこかで確認しているはず」と考えて指摘を閉じることもできません。認可処理が置かれた場所をコード上で確かめる必要があります。
空欄を残さない指摘票の記入例
| 欄 | 架空の記入内容 |
|---|---|
| 対象 | invoice_serviceのgetInvoice関数。請求書取得後からreturnまで |
| 期待する仕様 | 利用者は所有者が自分である請求書だけ閲覧できる |
| 観察したコード | requesterIdを受け取るが、所有者との比較がこの関数内にない |
| まだ不明な点 | 上位のAPIハンドラーで所有者確認を行っているか |
| 確認先 | getInvoiceの呼び出し箇所と認可処理。テスト用利用者A・Bの境界ケース |
| 修正案 | 認可の責任がこの関数にある設計なら、返却前に所有者一致を条件にする |
| 採否 | 上位処理を読んでから判断。現時点は指摘候補であり修正済みではない |
指摘票で大切なのは、危険という評価と、実際に読んだコードを分けることです。この例なら、引数が未使用という観察は示せても、外部から他人の請求書を取得できたという実測結果はありません。確認していない事実を記録に混ぜないことで、次の担当者が調べる範囲が明確になります。
修正案を条件式まで具体化する
所有者確認をこの関数で行うという設計判断が済んだなら、修正案は次のように表せます。実際の例外処理や返却形式は利用する言語とアプリケーションの仕様に合わせる必要があります。この疑似コードは動作検証済みのライブラリではありません。
getInvoice(invoiceId, requesterId):
    invoice = findInvoice(invoiceId)
    if invoice is missing:
        return unavailable
    if invoice.ownerId != requesterId:
        return unavailable
    return invoice
本人かどうかを返却前の条件に入れた点が、修正前との差です。ただし、これだけで全体の認可設計が完成したとは言えません。管理者による閲覧など別の仕様があるなら、単純な所有者一致だけでは正しい利用も拒否するかもしれません。既存仕様との照合が必要です。
修正差分に対応したテスト例
| 入力条件 | この例での期待結果 | 確認したい境界 |
|---|---|---|
| 利用者AがA所有の請求書を指定 | 請求書を返す | 正しい閲覧まで止めていないか |
| 利用者BがA所有の請求書を指定 | 請求書を返さない | 他の利用者のデータが返らないか |
| 存在しない請求書IDを指定 | 請求書を返さない | 未取得データをそのまま処理していないか |
| 管理者による閲覧 | 別途決めた仕様に従う | 所有者以外をすべて拒否してよい設計か |
ここで示しているのは期待結果の表であり、実行結果ではありません。テストコードを作った段階、実行した段階、結果を読んだ段階を分けて扱います。AIの回答中に「通りました」と書かれていても、実行記録がなければテスト完了の証拠には使えません。
作業の受け渡し方は、関連記事のClaude Codeの開発ワークフローでも整理しています。州政府の実施内容と、自組織で設計する工程を分けて参照してください。
人のレビューとAI支援レビューの役割分担
役割分担表とは、同じ請求書機能のレビューについて、人が読む場合とAIへ確認を依頼する場合で、何を根拠に判断するかを並べた設計例です。速度や精度の実測比較ではありません。
| 問い | 人がコードを読む場合 | AIへ確認を依頼する場合 | 採否判断に残す材料 |
|---|---|---|---|
| 利用者の識別情報はどこから来るか | APIハンドラーから引数までを追う | 読み取り対象を指定し、引数が渡される箇所の列挙を依頼する | 該当ファイルと呼び出し箇所。見ていない範囲は未確認と書く |
| 所有者一致はどこで確認するか | 認可処理と呼び出し順を照合する | 一致条件がある箇所と、見つからない箇所を分けた説明を依頼する | 実際の条件式と、その条件を通る経路 |
| 何を修正するか | 認可を担当する層を決め、既存設計に沿って変更する | 修正を依頼する場合も、変更可能なファイルと仕様を限定する | 修正差分。別の経路に同じ問題が残っていないか |
| 直ったと言えるか | 本人・他人・存在しないIDのテストを読む | テスト案と結果説明を区別して依頼する | 実際に実行したテストと結果。未実行の案は成功に数えない |
このように作業を分けると、AIの説明が整っているかだけで判断する必要がなくなります。説明中に示された条件式が本当に存在するか、テストが仕様を確認できているかを個別に調べられます。AIを使わないレビューでも同じ材料があれば判断できます。
比較表の違いは、誰が文章を作るかよりも、その文章が何を根拠にしているかにあります。「所有者チェックは実装されています」という回答があっても、別のAPIの条件式を引用していれば、この請求書機能の根拠にはなりません。逆にAIが「チェックが見つからない」と答えた場合も、与えた範囲に認可ミドルウェアが含まれていないなら、入力範囲が足りない可能性があります。見つからなかったという結果には、検索した範囲を添えると意味が明確になります。
費用を比較したい場合は、コードを読む作業だけでなく、指摘の確認、修正差分の確認、テスト、差し戻しにかかった時間も分けて集めます。本記事の架空例には実測時間も実請求額もないため、どちらが安いかの順位は付けません。州政府の20時間という値を、そのまま手元の作業費用へ換算することもできません。
行政・企業・個人開発者が検討を進める順序
検討を進める順序とは、事例の規模をまねるのではなく、小さな対象で「指摘の検証」「修正の承認」「結果の測定」を一巡させてから範囲を広げる進め方です。
州政府の事例は、規模の違う組織にそのまま当てはめられません。対象量だけを見て同じ計画を立てると、移行の難しさや検証の負担を見落とします。次の段階に分けて進めると、自分の課題との違いが見えやすくなります。
| 段階 | やること | 次へ進む条件 |
|---|---|---|
| 段階1:対象を決める | 小さなリポジトリか、重要度の高い一系統を選び、渡してよいデータ範囲を規程で確認する | 対象と禁止事項が文書になっている |
| 段階2:読み取り専用で確認する | ファイルを変更しない条件で、所有者確認や入力検証など決めた観点だけを調べてもらう | 各指摘にファイルと行が付き、担当者が開いて確かめられる |
| 段階3:指摘を仕分ける | 採用・不要・保留に分け、不要とした理由も残す | 仕分けの基準が複数の担当者で一致する |
| 段階4:修正とテストを承認する | 採用した指摘だけ差分とテストを作り、実行結果を読んで承認する | 実行記録と承認者が残っている |
行政機関・大きな組織で追加で確認すること
行政機関や大企業では、技術面に加えて、調達、情報管理、監査の観点が必要です。手順をまねるときは、自組織の承認フローと、公式ページに書かれた範囲を分けて読んでください。公式ページ以外の資料は、本記事では確認の対象にしていません。
個人開発者・小規模チームの場合
WordPressや受託開発などへの適用可否は、州政府の事例だけでは決まりません。個人や小規模チームでは、対象を一つの機能に絞り、先に述べた架空例のように仕様とコードの関係から指摘を確かめるほうが、成果と手間の関係を把握しやすくなります。本記事は、特定の業務で検出精度や効率が向上したという実績を示すものではありません。
利用開始前に準備すること
利用開始前の準備とは、AIに渡す対象・期待仕様・変更してよい範囲・回答に含めてほしい材料を、依頼文で先に決めておくことです。「セキュリティを改善して」といった曖昧な依頼では、返答を検証する物差しがありません。
ここでは前述の架空の請求書機能を、読み取りだけで調べてもらう場合の依頼文を作ります。実サービスの認証情報、顧客データ、機密コードをこの例へ埋め込む必要はありません。自組織で利用する場合は、提供可能なデータ範囲を組織の規程と利用サービスの条件で確かめてください。
レビュー依頼文の完成例
対象はテスト用のinvoice_serviceと、その呼び出し元のAPIハンドラーです。期待仕様は「利用者は自分の請求書だけ閲覧できる」です。今回はファイルを変更せず、所有者確認がどこにあるかを説明してください。
回答には、読んだファイル、所有者の比較条件、呼び出し経路、まだ確認できない部分を分けて書いてください。実際に読めないファイルの内容を補わないでください。テストを実行していない場合は、テスト案として提示してください。
対象と期待仕様を具体化しているため、返答に何が必要かを比較しやすくなります。ただし、この書き方で正解や検出漏れゼロが保証されるわけではありません。返答を実際のコードと照合する仕事は残ります。
返答を受け取った後の読み方
最初に読むのは結論だけでなく、読んだファイルの欄です。指定したAPIハンドラーが対象から抜けていれば、認可処理全体を調べた回答とは扱いません。次に、条件式と呼び出し経路を開き、説明に出てきた関数が実際にその経路で使われるかを確かめます。
返答に修正案が含まれていても、読み取りのみという依頼から自動適用へ切り替えません。修正の要否と担当箇所を決めた後に、別途変更範囲を明確にします。調査、変更、テストを一つの成功報告にまとめないことが、この依頼文を使う上での境界です。
料金とデータの確認は別に行う
料金やプランはClaude料金プラン解説と利用時点のAnthropic公式情報を照合します。州政府のケーススタディは、読者の契約プランや請求額の根拠ではありません。コードを渡す範囲については、Claude Codeを使う際のセキュリティ確認も参照してください。
よくある質問
- Q1. 20時間で修正とテストまで完了したという意味ですか?
-
いいえ。公式ケーススタディの20時間は、4億6,600万行のスキャンにかかった時間です。指摘の確認、修正、テスト、チームの承認は別の工程として説明されており、この20時間に含まれるとは書かれていません。
- Q2. 約6.5年というのは実際に測った時間ですか?
-
実測ではありません。公式ページは、従来の方法なら約6.5年かかりうるというチームの見積もりとして紹介しています。第三者が検証した比較ではないため、自組織の所要時間の予測には使えません。
- Q3. 4.66億行という数字から検出精度を計算できますか?
-
できません。対象の行数と時間だけでは、正しく指摘した問題数、誤った指摘数、見逃した問題数が分からないためです。スキャンの規模を示す数字と、指摘が正しいかという評価は別です。
- Q4. パッチはAIが自動で本番に反映したのですか?
-
公式ページは、出荷前にチームがレビューして承認したと説明しています。AIの出力がそのまま本番に反映されたとは書かれていません。自組織で運用する場合も、承認者と承認の基準を先に決めておく必要があります。
- Q5. 請求書のコード例はアルバータ州政府のものですか?
-
いいえ。invoice_serviceの疑似コードと指摘票は、この記事のために作った架空例です。政府システムの実装や、政府で見つかった不具合を再現したものではありません。
- Q6. requesterIdが未使用なら、すぐに修正してよいですか?
-
この例では、先に呼び出し元の認可処理を調べます。APIハンドラーで同じ所有者チェックを済ませている設計なら、修正すべき場所が違ったり、追加変更が不要だったりするためです。引数が未使用という観察だけで、外部から他人の請求書を取得できると断定しません。
- Q7. AIが「テストは通った」と回答したら採用できますか?
-
回答文だけでは実行したことを確認できません。実行したテスト、対象コード、出力結果を対応させます。本記事のテスト表は期待結果の設計例であり、実行済みの結果ではありません。
- Q8. 費用が安くなるかは、この事例から分かりますか?
-
分かりません。公式ケーススタディ本文には、この取り組みの費用額が書かれていませんでした。時間を集める場合は、読む時間に加えて指摘の確認、修正、テスト、差し戻しも対象にして、自組織で測ります。
- Q9. 日本の企業や自治体でも同じ結果になりますか?
-
同じ結果になるとは言えません。公式事例は一つの州の省の取り組みであり、コードの量、言語、体制、規程が違えば結果も変わります。小さな対象で指摘の検証と承認を一巡させてから、範囲を広げるかを判断します。
まとめ
Anthropicの公式ケーススタディは、アルバータ州のMinistry of Technology and InnovationがClaude Codeを使い、4億6,600万行のコードを20時間でスキャンした事例を紹介しています。これは発表元が報告した個別事例であり、一般的な性能保証や他組織での再現結果を意味しません。
本記事で確認したポイントを整理します。
- 4.66億行/20時間は報告された実績、約6.5年はチームの見積もり、185→16アプリは計画。種類を分けて読む
- スキャンはルールエンジンとClaudeの二段で行われ、指摘にはファイルと行が付き、パッチは出荷前にチームが承認した
- 数値の意味と、検出精度・検出件数・費用は分けて確認する(公式本文に費用額や件数の記載はなかった)
- 導入時は対象範囲、権限、確認担当者、承認の基準、渡してよいデータを先に決める
- 行政・企業・個人開発者のいずれも、小さな対象で読み取り専用の確認から始め、結果を測ってから広げる
AIコードレビューを試す場合は、対象範囲と確認手順を先に決めます。まずは手元の小さなコードベースで、説明やレビュー補助など一つの用途から検証してください。
AI×SNSで「普通の人」が成果を出す方法を、無料で体系的に学べる内容です
Claude Codeのような最新AIツールをどうビジネスや発信に活かすか——S.Lineでは、AIを活用して成果を出す具体的な方法をLINE登録者に無料でお届けします。
ツールの使い方だけでなく、実際の活用事例や再現性の高いノウハウを体系的に学べる構成です。
※本記事は2026年7月6日公開の公式ケーススタディ時点の公開情報をもとにしています。
次に読みたい関連記事
セキュリティ確認の具体例と開発運用の情報を参照できます。
このテーマの全体像: Claudeの料金・モデル・始め方まとめ
あわせて読みたい・姉妹メディア