Claude Code の「Dynamic Workflows(動的ワークフロー)」は、Claude が書いた JavaScript のスクリプトで多数のサブエージェントを動かし、その流れを何度でも再実行できる仕組みです。
公式ドキュメント「Orchestrate subagents at scale with dynamic workflows」は、コードベース全体の監査、大規模な移行、出典を突き合わせる調査といった用途を挙げています(2026年9月30日確認)。
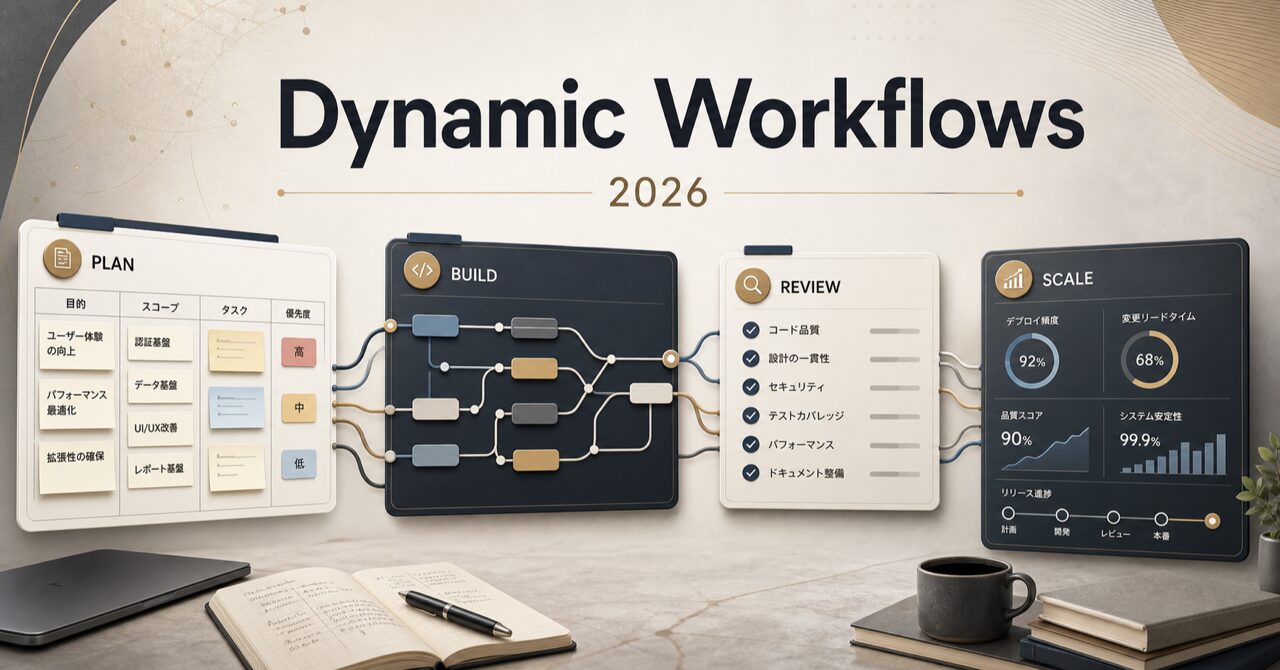
1人のエンジニアが1つの対話で回していた開発の一部を、「調べる→設計する→実装する→レビューする→検証する」という工程ごとのエージェントに分け、並列で走らせる発想です。
本記事は、この機能を大規模開発でどう使い、どこに落とし穴があるのかを、公式ドキュメントに書かれている範囲だけで整理します。モデル名と料金は、2026年9月28日に取得した公式ページの表記に合わせて更新しました。
- Dynamic Workflows は普通の Claude Code とどう違うのか?
- 大規模なコードベースで、なぜ単一エージェントより速く・正確に進められるのか?
- 現行のモデル(Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 4.5)をどう使い分け、料金はいくらなのか?
- 導入のデメリットや失敗パターンは何か、どう避けるのか?
AIは「使い方を設計できた人」が伸びます。
まずは一つの作業から試して、結果を見ながら広げてみてください。
Dynamic Workflows とは?
Claude Code で、Claude が書いたスクリプトに沿って多数のサブエージェントを動かす機能です。公式ドキュメントでは、全有料プランと Anthropic API で利用でき、Pro では /config の「Dynamic workflows」の行からオンにする、と説明されています。
本記事では、仕組み・部品・使い分け・コストの見方を整理し、2026年9月時点の現行モデルとの組み合わせ方まで解説します。
この記事でわかること
【完全無料】AI×SNSで成果を出す100大特典を受け取る
AIの使い方を、SNS運用の実務につなげたい方へ。LINEで特典の案内を受け取れます。
- Dynamic Workflows とは何か(まず全体像をつかむ)
- なぜ大規模開発で Dynamic Workflows が効くのか
- Dynamic Workflows の基本部品
- 現行モデルの選び方(2026年9月時点)
- 利用枠・上限・コストの見方
- 大規模開発での代表的な使い方パターン
- パイプライン と 並列(バリア)の使い分け
- 品質を担保する仕組み
Dynamic Workflows とは何か(まず全体像をつかむ)
Dynamic Workflows は、Claude Code が多数のサブエージェントを1本の JavaScript スクリプトで動かす仕組みです。Claude がタスクに合わせてスクリプトを書き、ランタイムがバックグラウンドで実行するため、実行している間も対話セッションを使い続けられます。
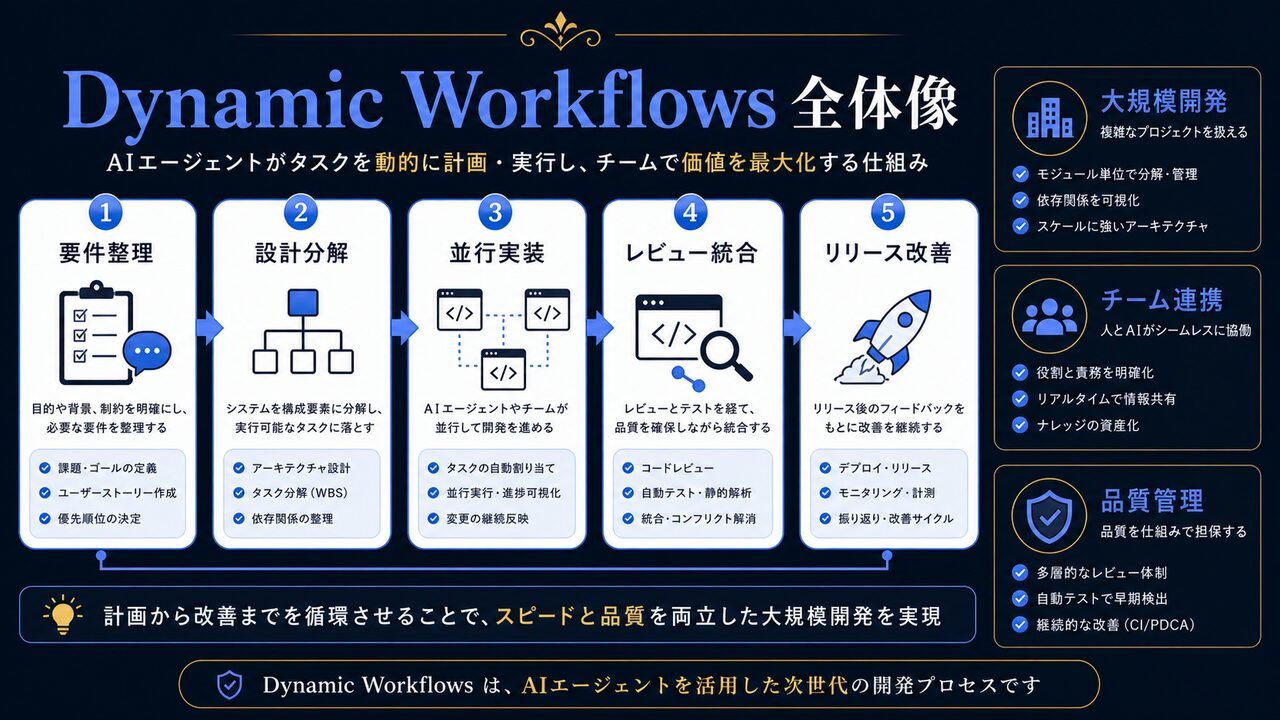
公式ドキュメントは、Dynamic Workflows を「スクリプトが次に何を走らせるかを決める」仕組みとして説明しています(公式: Dynamic workflows、2026年9月30日確認)。
従来のサブエージェントでは、Claude が1ターンごとに次に何を起動するかを判断し、その結果はすべて Claude の文脈(コンテキストウィンドウ)に入ります。
ワークフローでは、ループ・分岐・中間結果をスクリプト側の変数が保持し、Claude の文脈に残るのは最終的な答えだけです。
つまり「考える部分はモデル、流れの骨格はスクリプト」という役割分担になります。
「自律エージェント」と「ワークフロー」の違い
自律的に動くエージェントは、次の一手をモデル自身がその場で選びます。
柔軟ですが、数百ファイル規模の作業では、途中で抜けや偏りが出ても気づきにくい面があります。
ワークフローは、何を並列に走らせ、どこで検証し、どう統合するかを、読んで再実行できるスクリプトとして残せます。
公式ドキュメントも、サブエージェント・スキル・エージェントチーム・ワークフローの違いを「誰が計画を持っているか」で整理しています。
ワークフローの場合、計画を持つのはスクリプトです。
提供状況と最初に確認すること
公式ドキュメントの冒頭には、Dynamic Workflows は全有料プラン、Anthropic API、Amazon Bedrock、Google Cloud の Agent Platform、Microsoft Foundry で利用でき、Pro プランでは /config の「Dynamic workflows」の行からオンにする、と書かれています(公式ドキュメント、2026年9月30日確認)。
以前の本記事では「research preview」と紹介していましたが、2026年9月30日時点の同ページには、その表記は確認できませんでした。
提供条件や画面上の名称は更新されることがあるため、導入前に最新のドキュメントを開き、自分のプランと Claude Code のバージョンで使えるかを確かめてください。
なぜ大規模開発で Dynamic Workflows が効くのか
大規模開発の難しさは、コードの行数そのものより、作業が1つの文脈に収まりきらない点にあります。Dynamic Workflows は作業を分割し、各サブエージェントに必要な範囲だけを渡して並列に処理できるため、この制約を避けやすくなります。
数百ファイルの監査、横断的なリファクタリング、全モジュールのレビューは、1つの対話に詰め込むと文脈が溢れます。
公式ドキュメントは、ワークフローが向く場面として、1つの対話では調整しきれない数のエージェントが必要なときと、オーケストレーションをスクリプトとして読み返し・再実行したいときを挙げています(公式ドキュメント)。
規模の目安としては、通常のサブエージェントが「1ターンに数件の委任」、ワークフローが「1回の実行で数十から数百のエージェント」と対比されています。
1つの文脈に収まらない作業を分解できる
たとえば「200ファイルの命名規則違反を洗い出す」場合、1つのエージェントが全ファイルを読むと文脈が枯渇します。
ワークフローなら、ファイル一覧を先に作り、ファイルごとにサブエージェントを割り当て、各自が担当範囲だけを読んで結論を返します。
公式ドキュメントの例でも、ルートハンドラの認証チェック監査を「1ファイルにつき1エージェント」に展開し、結果を集めて検証する流れが紹介されています。
親側は結論だけを集約するので、文脈を浪費しません。
並列化で待ち時間を圧縮できる
独立した作業を同時に走らせれば、全体の所要時間は「逐次の合計」ではなく「最も遅い1本」に近づきます。
レビューを観点別(バグ・性能・セキュリティ)に分けて並列で実行し、見つかった指摘だけを検証に流す、といった設計が考えられます。
ただし同時に動かせる数には上限があります。既定は最大16エージェントで、詳しくは後述の「利用枠・上限・コストの見方」で扱います。
あなたのInstagramをAIで無料診断
S.Earch(SNS分析AI)が、約30秒であなたのアカウントの弱点と次の一手を可視化します。
7日間完全無料・カード登録不要、その後も自動でフリープランに移行します。
まず1問だけ試したい方は 登録不要でAIに質問
Dynamic Workflows の基本部品
ワークフローのスクリプトは、agent()・pipeline()・parallel()・phase()・log() といった関数と、args という変数で組み立てます。それぞれの役割を押さえると、生成されたスクリプトを読んで設計の良し悪しを判断できるようになります。
公式ドキュメントによると、保存されたスクリプトは先頭に meta ブロック(名前と説明)を置き、その後ろに、トップレベルで await を使える通常の JavaScript を書く形です(公式ドキュメント、2026年9月30日確認)。
普段はスクリプトを手で書く必要はなく、Claude が生成したものを読んで意図どおりか確かめる使い方が中心になります。
agent / parallel / pipeline / phase の役割
公式ドキュメントに登場する主な部品は次のとおりです。
agent() は1つのサブエージェントを起動して結果を返します。
pipeline() はリストの各項目に対して1つずつエージェントを走らせます。
parallel() は複数のエージェント作業を同時に走らせ、すべての完了を待ちます。
phase() は、続くエージェントを進捗表示の中で1つのタイトルにまとめます。
log() は、進捗画面のフェーズの上にメッセージを表示します。
保存したワークフローには args という変数でリストや設定を渡せるため、対象のパスや調べたい質問を、スクリプトを書き換えずに差し替えられます。
構造化出力でデータをそのまま受け取る
agent() に schema(JSON スキーマ)を渡すと、そのサブエージェントは文章ではなく、スキーマに合った JSON を返します。
公式ドキュメントによれば、出力が検証に通らない場合は最大5回まで再試行され、それでも失敗すると、最後の検証エラーを含むエラーになります(公式ドキュメント)。
再試行の回数は、環境変数 MAX_STRUCTURED_OUTPUT_RETRIES で変えられると説明されています。
大規模な集計や監査では、この「形を決めて受け取る」設計が後工程の自動化を支えます。
スクリプトの実行時に守られる制約
ランタイムには、いくつかの制約があります。
実行の途中でユーザー入力を挟むことはできません。段階ごとに確認したいときは、段階を別々のワークフローに分けます。
スクリプト自体はファイルシステムやシェルに直接触れず、読み書きやコマンド実行はエージェントが担当します。
モジュールの読み込み(import)を含むスクリプトは、実行開始前に失敗します。
また、再現性を保つため、スクリプト内で Date.now() や Math.random() を呼ぶとエラーになります。時刻が必要なら args で渡します(公式ドキュメント)。
現行モデルの選び方(2026年9月時点)
2026年9月28日に取得した Anthropic の公式モデル一覧では、現行モデルは Claude Fable 5.1、Claude Opus 5.5、Claude Sonnet 5.5、Claude Haiku 4.5 の4つです。難しい推論はFable 5.1、長時間のコーディングは Opus 5.5、速度と知能のバランスは Sonnet 5.5、軽量・高速な処理は Haiku 4.5、という位置づけで公式が説明しています。
出典は Anthropic 公式のモデル一覧(Models overview)です。
同ページの説明では、迷ったら Opus 5.5 から始め、より難しい推論や長時間のエージェント作業が必要なとき、または Opus 5.5 を高い effort で評価しても足りないときに Fable 5.1 を使う、とされています。
ワークフロー内の各エージェントのモデルは、サブエージェントと同じ優先順位で決まり、スクリプトが段階ごとに指定したモデルは「呼び出しごとのモデル」として扱われます。何も指定がなければセッションのモデルで動きます(公式ドキュメント)。
ワークフロー内での役割分担
設計や統合のように判断の重い段階には上位のモデル、広く浅い探索や分類には軽量のモデル、というように配分すると、品質とコストの折り合いをつけやすくなります。
公式ドキュメントは、コストを抑える方法として、大規模な実行の前に /model を確認することと、強力なモデルが不要な段階には小さなモデルを使うようタスクの説明で Claude に頼むことを挙げています(公式ドキュメント)。
迷う場合は、まず既定(セッションのモデル)のまま小さな範囲で試し、結果とトークン使用量を見てから配分を調整するのが無難です。
Sonnet の「最新版」の表記について(公式ページの更新差)
Sonnet 系については、公式ページ同士で表記が食い違っていた時期がありました。
モデル一覧(Models overview)は Claude Sonnet 5.5(API ID は claude-sonnet-5-5)を現行として掲載し、Claude Sonnet 5 と Claude Sonnet 4.6 は「legacy(まだ利用可能)」の一覧に置いています。
料金ページ(claude.com/pricing)は、2026年9月28日の取得時点では「Latest models」欄に Claude Sonnet 5 の表記が残っていましたが、2026年9月30日に確認し直すと、同欄は Claude Sonnet 5.5(入力 $2、出力 $10)に更新され、Sonnet 5 は Legacy models 側に移っていました。公式ページは更新のタイミングで表記が揺れることがあるため、利用前にモデル一覧と料金ページの両方を確認してください。
なお、以前の本記事で扱っていた Claude Sonnet 4 は、同じ一覧の現行・legacy のどちらにも載っていません。古い解説記事の記述をそのまま使わないよう注意が必要です。
| モデル | 公式の説明(要旨) | API料金(入力 / 出力、100万トークンあたり・USD) | コンテキスト |
|---|---|---|---|
| Claude Fable 5.1 | 高度な推論と長時間のエージェント作業向け | $10 / $50 | 1Mトークン |
| Claude Opus 5.5 | 長時間のエージェント型コーディングと知識作業向け | $4 / $20 | 1Mトークン |
| Claude Sonnet 5.5 | 速度と知能のバランスを重視 | $2 / $10 | 1Mトークン |
| Claude Haiku 4.5 | フロンティア級に近い知能を備えた最速モデル | $1 / $5 | 200Kトークン |
上の表は、公式モデル一覧の2026年9月28日取得時点の掲載内容です。料金は API 経由の標準価格で、Claude の個人プラン(Pro・Max)の月額とは別の体系です。
プランの月額は 公式料金ページで確認でき、同日の取得時点では、Free が $0、Pro が年払い換算で月 $17(月払いは $20)、Max が月 $100 から、Claude Code は Pro と Max に含まれる、という掲載でした。
利用枠・上限・コストの見方
ワークフローは多数のエージェントを起動するため、同じ作業を1つの対話でこなすより、トークン使用量が大きく増えることがあります。公式ドキュメントでは、実行分もプランの利用枠とレート制限に数えられると説明されています。
公式ドキュメントは、大きな作業に入る前に、まず小さな範囲(リポジトリ全体ではなく1ディレクトリ、広い質問ではなく絞った質問)で試すことを勧めています(公式ドキュメント、2026年9月30日確認)。
進捗画面(/workflows)にはエージェントごとのトークン使用量が見え、実行はそこからいつでも止められます。
以下では、ドキュメントに数値が明記されている上限とコスト関連の仕組みを整理します。
同時実行数と1回の実行の上限
公式ドキュメントに書かれている上限は次のとおりです。
同時に動くエージェントは既定で最大16で、CPU が少ない環境ではそれより減ります。環境変数 CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS で1から256まで変更でき、この変更には Claude Code v2.1.269 以降が必要です。
1回の parallel() または pipeline() に渡せる項目は最大4,096件で、超えるとエラーになります。
1回の実行で起動できるエージェントは合計1,000個までで、暴走したループを防ぐ目的だと説明されています。
コストを下げる3つの手段
大規模なファンアウトでは出力トークンが積み上がるため、削減手段を組み合わせます。
1つ目は、API の Batch API です。公式モデル一覧には「Batch API のリクエストは50%オフ」と書かれています。
2つ目は、プロンプトキャッシュです。同じページに、キャッシュの読み取りは基本の入力価格の10%(Claude Fable 5.1 は2.5%、Claude Opus 5.5 は5%)と記載されています(Models overview、2026年9月28日取得)。
3つ目は、キャッシュを共有しやすい設計にすることです。同じモデル・effort・エージェント種別・ツール・出力スキーマ・作業ディレクトリで動くエージェントは、先に動いた兄弟のキャッシュを読めます。ワークフローのエージェントのキャッシュは既定で5分保持され、subagentPromptCacheTtl を 1h にすると1時間になりますが、1時間分の書き込みは高い料金で請求されます(公式ドキュメント)。
規模の目安を伝える「size guideline」
Claude がワークフローを書くときに狙うエージェント数は、size guideline で助言できます。値は unrestricted(目安なし)、small(5未満)、medium(10未満)、large(50未満)の4つです。
既定は mediumで、v2.1.271 以降の Pro プランでは small が既定になります。あくまで助言であり上限ではないため、プロンプトで別の規模を求めればそちらが優先されます(公式ドキュメント)。
ワークフローが25を超えるエージェントを予定するか、見込みのトークン総量が150万を超えると、進捗行に「Large workflow」の警告が出ます。警告は助言であり、実行を止めたり制限したりはしません。
| 手段 | 公式に書かれている内容 | 使いどころ |
|---|---|---|
| Batch API | リクエストが50%オフ | 即時の応答が不要な大量処理 |
| プロンプトキャッシュ | 読み取りは基本の入力価格の10%(モデルにより2.5%・5%) | 同じ前提・指示を多数のサブエージェントで共有する場面 |
| size guideline | small / medium / large で狙うエージェント数を助言 | 実行規模を抑えたいとき |
| モデルの使い分け | 段階ごとに小さなモデルを指定するよう頼める | 探索・分類など軽い段階 |
大規模開発での代表的な使い方パターン
大規模開発でのワークフローは、「理解・設計・レビュー・移行」のように1フェーズで完結する小さな型を積み重ねる使い方が扱いやすくなります。各フェーズの結果を人間が確認してから次へ進めば、制御を握ったまま規模を広げられます。
公式ドキュメントの例文集には、多数のファイルを同じ観点で監査する、チェックが通るまで修正を繰り返す、多数のファイルを並列で移行する、変更ファイルをレビューして1つの要約にまとめる、複数の情報源にまたがって調べる、新しい発見がなくなるまで探す、という6つの型が並んでいます(公式ドキュメント、2026年9月30日確認)。
以下では、その中から大規模開発で使いやすい型を、実務の順序に沿って整理します。
理解・設計・レビュー・移行の4型
代表的な使い方を4つに整理します。
理解:サブシステムごとに並列で読み、構造マップに集約する。
設計:複数の独立した案を出し、審査して統合する。
レビュー:観点で分けて探索し、見つけた指摘を検証する。
移行:対象箇所を洗い出し、各所を変換して検証する。
公式ドキュメントの移行の例では、対象ファイルを見つけ、ファイルごとに分離したコピーで変換して編集の衝突を避け、結果を検証する流れが示されています。
大きな仕事は、これらを別々のワークフローとして順に連結します。
「先に下見、それから展開」の現実解
作業対象の一覧が事前に分からないことは多いものです。
その場合は、まず対話で下見をしてリスト(対象ファイル・ディレクトリ・差分範囲)を作り、次にワークフローでそのリストを処理する「ハイブリッド」が現実的です。
公式ドキュメントのスクリプト例も、最初の agent() でファイル一覧を JSON スキーマ付きで取得し、その一覧を pipeline() に渡す構成になっています。
流れの形が決まる前に無理に並列化しないのがコツです。
パイプライン と 並列(バリア)の使い分け
複数の項目を段階的に処理する作業では、まず pipeline() を検討します。公式ドキュメントは pipeline() を「リストの項目ごとに1つずつエージェントを動かす」関数、parallel() を「複数のエージェント処理を同時に走らせ、すべての完了を待つ」関数と説明しています。このため parallel() は全項目の完了を待つ同期点(バリア)として働き、前段の全結果が次の段に必要なときに向きます。項目ごとに独立して進められる処理を pipeline() に寄せるのは、公式の記述ではなく設計上の一般的な整理です。
pipeline() では、ある項目が3段目にいる間に、別の項目が1段目にいても構いません。
全体の所要時間は「最も遅い1本の通し時間」に近づきます。
公式ドキュメントは、pipeline() を「リストの各項目に対して1つずつエージェントを走らせる」もの、parallel() を「エージェント作業の集合を同時に走らせ、すべての完了を待つ」ものと説明しています(公式ドキュメント)。
バリアが正しい場面・そうでない場面
バリア(全件の同期)が正しいのは、次の段が前段の全結果を必要とするときです。
重複を全件まとめて取り除いてから次へ進む、合計件数がゼロなら以降を丸ごと省く、といったケースが該当します。
一方、「平坦化したい」「整形したい」程度の理由では、バリアを置く根拠になりません。
それらは、パイプラインの1段の中で処理できます。
判断のための簡単な目安
並列で集めた結果を、単に map や filter で加工してから次の並列に渡すだけなら、その中間処理はバリアを必要としません。
前段の結果同士を比較・統合する必要があるときだけバリアを選ぶ、と覚えておくと迷いません。
なお、いずれを選んでも、agent() は手動で止めたり回復不能な API エラーに当たったりすると null を返します。pipeline() はその null を結果の配列に残すため、公式のスクリプト例では最後に .filter(Boolean) で取り除いています。
| 観点 | pipeline() | parallel()(バリア) |
|---|---|---|
| 公式の説明 | リストの各項目に1つずつエージェントを走らせる | 作業の集合を同時に走らせ、すべての完了を待つ |
| 段階間の同期 | 項目ごとに1エージェントを動かす(待ち方の詳細は公式ドキュメントに明記なし) | 全件の完了を待つ |
| 向く用途 | 各項目が独立して処理できる作業 | 重複排除・全件統合・ゼロ件での早期終了 |
| 選び方の目安 | まずこちらを検討する | 前段の全結果が必要なときだけ |
品質を担保する仕組み
規模を広げると、もっともらしいが誤った結論が混ざるリスクが高まります。Dynamic Workflows は、独立したエージェントに互いの指摘を検証させるなど、繰り返し使える品質確認の型をスクリプトに組み込めるのが特徴です。
公式ドキュメントは、計画をコードに移すことで、エージェントを増やすだけでなく、独立したエージェントが互いの指摘を敵対的にレビューしてから報告する、複数の観点で計画案を作って比較する、といった型を適用できると説明しています(公式ドキュメント、2026年9月30日確認)。
同梱の /deep-research は、複数の角度でWeb検索を展開し、見つけた情報源を取得して突き合わせ、各主張に投票して、出典付きのレポートを返すワークフローです。検証エージェントが確認できなかった主張は、反証されたものとしてではなく「未確認」として報告に載ります。
敵対的検証(adversarial verify)
1つの指摘に対し、複数の検証エージェントを「反証せよ」という姿勢で当てます。
多数が反証したら、その指摘は捨てます。
これにより、表面的に説得力があるだけの誤検出が生き残りにくくなります。
観点を変えた検証(正しさ・セキュリティ・再現性)を割り当てると、見落とす失敗モードが減ります。
公式ドキュメントの例文にも、「各指摘を報告前に敵対的に検証する」ようワークフローを頼む書き方が載っています。
枯れるまで回す(新しい発見がなくなるまで)
件数が読めない探索(バグ・課題・エッジケース)では、新しい発見が数ラウンド続けてゼロになるまで探索を続けます。
公式ドキュメントの例では、「不安定なテストを探し、2ラウンド続けて新しい発見がなければ止める」という指示が示されています。
「上位N件で打ち切る」より取りこぼしが減ります。
打ち切りや間引きを行うなら、何を落としたかをログに残すのが誠実な設計です。
導入ステップ:小さく始めて広げる
導入は、結果を人間が確認しやすい単発のタスクから始め、1つのワークフローを「うまく区切った1回のファンアウト」と捉えて段階的に連結するのが安全です。実行前に進捗画面とスクリプトを見られるので、最初は小さな範囲で挙動を確かめます。
公式ドキュメントによれば、実行前には計画されたフェーズが表示され、「Yes, run it」で開始、「View raw script」でスクリプトを確認、「No」で取り消しを選べます。表示されるかどうかは権限モードで変わります(公式ドキュメント、2026年9月30日確認)。
手動モードや accept edits モードでは毎回、auto モードでは初回のみ確認が出て、claude -p や Agent SDK では確認画面は出ず、権限ルールや hook などで承認する仕組みです。
最初の一歩に向くタスク
レビュー(観点別の指摘出し→検証)、コードベースの理解(並列読解→構造マップ)、命名や規約の一括点検は、結果の正しさを人間が確認しやすく、最初の一歩に向きます。
出力をスキーマで受け取れば、後工程の自動化もしやすくなります。
公式ドキュメントは、コストが読めない段階では小さな範囲で先に試し、進捗画面のトークン使用量を見ながら判断することを勧めています。
段階的に連結する
理解→設計→実装→レビューを別々のワークフローとして順に走らせ、各結果を読んでから次のフェーズを決めれば、人間が判断の主導権を保てます。
使い慣れた流れができたら、/workflows で実行を選び、s キーで、そのスクリプトをコマンドとして保存できます。保存先は、プロジェクトの .claude/workflows/(リポジトリを共有する全員向け)か、ホームの ~/.claude/workflows/(自分だけ)です(公式ドキュメント)。
プラグインに含めてチームやリポジトリをまたいで配布する方法も、同じドキュメントに説明があります。
岡田颯太
大事なのは「再現性」だと考えています。
Dynamic Workflows の価値は、流れを型にして、誰が回しても同じ手順で確認できる点にあります。
まずは観点別レビューのような小さな型を1つ作り、結果を見て広げてみてください。
デメリットと注意点(正直なところ)
Dynamic Workflows の注意点は、トークン消費が増えやすいこと、過剰な並列設計で速度が落ちること、そして提供条件やバージョン要件が更新されうることです。小さな範囲での試行と、公式ドキュメントの再確認で、多くのリスクは抑えられます。
有用な仕組みですが、向かない場面や見落としやすいコストがあります。
導入前に押さえておくと、判断を誤りにくくなります。
コストとトークン消費
サブエージェントを多数起動すれば、その分トークンが積み上がります。
公式ドキュメントは、1回の実行が同じ作業を対話で進めるより意味のある量のトークンを使うことがあり、その分は利用枠とレート制限に数えられると明記しています(公式ドキュメント)。
さらに、/effort ultracode をオンにすると、Claude が実質的なタスクごとにワークフローを計画するため、各リクエストのトークン消費と所要時間が増え、サブスクリプションでは利用上限に早く達すると説明されています。
Batch API・プロンプトキャッシュ・モデルの使い分けで抑える設計を、最初から織り込んでおくのが安全です。
過剰並列と設計ミス
本来パイプラインで十分な処理にバリアを多用すると、速い処理が遅い処理を待ち、並列の利点が削がれます。
また、同時実行には上限があります。
「並列にすれば速い」という思い込みより、依存関係に沿った設計が効きます。
途中で失敗したエージェントがあると、再開時にその後に始まったエージェントも再実行されます。公式ドキュメントは、A・B・C・D の順に始めて B が失敗した場合、A は保存結果を返し、B・C・D は再実行されると例示しています。
利用上限とバージョン要件
実行中にエージェントが claude.ai の利用上限に当たると、実行は失敗せず一時停止し、上限が解除されるとまもなく再開します。ただし、この挙動には Claude Code v2.1.271 以降、対話セッションでの claude.ai サブスクリプションへのサインイン、autoContinueAtUsageLimit のオン、24時間以内のリセットなど、複数の条件があります。条件を満たさないと、該当のエージェントは失敗します(公式ドキュメント、2026年9月30日確認)。
また、/effort ultracode の利用には v2.1.203 以降が必要です。
単純な逐次タスクや軽微な修正に多エージェントを持ち出すのは過剰で、かえって遅く高くつくこともあります。規模に見合う使い方を選ぶのが肝心です。
他のアプローチとの比較
大規模な作業を任せる方法は、サブエージェント、スキル、エージェントチーム、ワークフローの4つに大別できます。違いは「次に何を走らせるかを誰が決めるか」で、ワークフローだけは、その計画をスクリプトが持ちます。
公式ドキュメントの比較表(公式ドキュメント、2026年9月30日確認)を、実務の判断に使いやすい形で整理します。
小さな修正や1ファイルの作業は、単一の対話(あるいは少数のサブエージェント)のほうが速く、文脈も一貫します。
文脈に収まらない横断作業、大量の独立タスク、同じ手順を何度も回したい作業では、ワークフローの分割と並列が効きます。
境目は「1つの文脈に収まるかどうか」と「オーケストレーションを読み返して再実行したいかどうか」です。
サブエージェントの基本は、当サイトのClaude Codeのサブエージェント使い方でも解説しています。
4つの方法の違い
比較の軸は、計画を誰が持つか、途中結果がどこに残るか、繰り返し使えるのは何か、規模はどれくらいか、の4つです。
サブエージェントとスキルは、次の一手を Claude がターンごとに決め、途中結果も Claude の文脈に入ります。
エージェントチームは、リードのエージェントが並行して動くセッションを監督します。
ワークフローは、ループ・分岐・途中結果をスクリプトの変数が持ち、再利用できるのはオーケストレーションそのものです。
| 観点 | サブエージェント | ワークフロー |
|---|---|---|
| 次に何を走らせるかを決める主体 | Claude がターンごとに決める | スクリプトが決める |
| 途中結果の置き場所 | Claude の文脈 | スクリプトの変数 |
| 繰り返し使えるもの | ワーカーの定義 | オーケストレーションそのもの |
| 規模の目安(公式の表記) | 1ターンに数件の委任 | 1回の実行で数十から数百のエージェント |
| 中断したとき | そのターンをやり直す | 同じセッション内で再開できる |
よくある質問
- Q1. Dynamic Workflows は誰でも今すぐ使えますか?
-
公式ドキュメントには、全有料プラン、Anthropic API、Amazon Bedrock、Google Cloud の Agent Platform、Microsoft Foundry で利用でき、Pro では
/configの「Dynamic workflows」からオンにする、と書かれています。無料プランでの提供は記載がないため、確認できていません。最新の条件は公式ドキュメント(2026年9月30日確認)でご確認ください。
- Q2. どのモデルを使えばよいですか?
-
公式モデル一覧は、迷ったら Claude Opus 5.5 から始め、より難しい推論や長時間のエージェント作業には Claude Fable 5.1 を使う、としています。
ワークフロー内のエージェントは、指定がなければセッションのモデルで動きます(Models overview、2026年9月28日取得)。
- Q3. 現行モデルの料金はいくらですか?
-
API の標準価格(100万トークンあたり・USD、入力 / 出力)は、Fable 5.1 が $10 / $50、Opus 5.5 が $4 / $20、Sonnet 5.5 が $2 / $10、Haiku 4.5 が $1 / $5です。
出典は公式モデル一覧(2026年9月28日取得)です。Sonnet 5.5 は、2026年9月30日に確認した時点の料金ページでも同額(入力 $2 / 出力 $10)で掲載されています。
- Q4. Sonnet 4 や Sonnet 4.6 は、いまも最新ですか?
-
最新ではありません。公式モデル一覧では、Sonnet 4.6 は legacy(まだ利用可能)の一覧にあり、Sonnet 4 は現行・legacy のどちらにも載っていません(Models overview、2026年9月28日取得)。
古い解説記事の記述は、公式の最新表記で確認し直してください。
- Q5. コストを抑える具体策は?
-
まず小さな範囲で試して、
/workflowsでトークン使用量を見ます。そのうえで、Batch API(50%オフ)、プロンプトキャッシュ(読み取りは基本の入力価格の10%など)、段階ごとのモデルの使い分け、size guideline による規模の助言を組み合わせます。
- Q6. パイプラインと並列はどちらを選べばよいですか?
-
まず pipeline() を検討します。
前段の全結果をまとめて使う必要がある(重複排除・全件統合・ゼロ件での早期終了)ときだけ、parallel() のバリアを選びます。
単なる整形や平坦化は、パイプラインの1段で済みます。
- Q7. 同時に何個のエージェントを動かせますか?
-
公式ドキュメントでは、既定で最大16エージェントの同時実行で、CPU が少ない環境ではそれより減ります。1回の実行の合計は1,000エージェントまでです。
同時実行数は環境変数で1から256まで変更できます(v2.1.269 以降)。
- Q8. 小さなチームでも導入する価値はありますか?
-
規模が小さくても、横断レビューや大量の独立タスクがあるなら検討の余地があります。
逆に局所的な修正中心なら、単一の対話で十分です。
「1つの文脈に収まるか」を判断基準にすると、過不足なく選べます。
用語集
| 用語 | 意味 |
|---|---|
| Dynamic Workflows | Claude が書いたスクリプトで、多数のサブエージェントを動かす Claude Code の機能 |
| サブエージェント | 親から特定の作業を任され、結果を返す個別のエージェント |
| pipeline() | リストの各項目に1つずつエージェントを走らせる関数 |
| parallel()(バリア) | 作業の集合を同時に走らせ、すべての完了を待つ関数 |
| ファンアウト | 1つの作業を多数のサブエージェントへ一斉に展開すること |
| 敵対的検証 | 指摘を「反証せよ」という姿勢で複数のエージェントが検証し、誤検出を除く手法 |
| プロンプトキャッシュ | 共通の前提・指示を再利用し、読み取り時の入力コストを下げる仕組み |
| Batch API | 即時応答が不要な処理を、公式表記で50%オフにする API |
| size guideline | Claude がワークフローを書くときに狙うエージェント数の助言(small / medium / large / unrestricted) |
| ultracode | 実質的なタスクごとに Claude がワークフローを計画する設定(/effort ultracode) |
まとめ
Dynamic Workflows は、大規模開発の制約である「1つの文脈に収まらない」を、分割と並列で乗り越えるための仕組みです。
理解・設計・レビュー・移行という小さな型を、パイプラインを基本に連結し、敵対的検証や、新しい発見がなくなるまで回す設計で品質を担保します。
2026年9月時点の現行モデルは、公式モデル一覧で Fable 5.1・Opus 5.5・Sonnet 5.5・Haiku 4.5 の4つです。段階ごとに役割を分ければコストも調整できます。
一方で、トークン消費、過剰並列、上限やバージョン要件という注意点もあります。
小さく始めて結果を見ながら広げる、この進め方が、規模に振り回されない近道です。
AI×SNSで「普通の人」が成果を出す方法を、無料で体系的に学べます
Claude や Claude Code を使った効率化から、SNSでの価値提供・収益化までを、初心者でも再現できる手順に落とし込んで公開しています。
まずは無料で全体像をつかんでください。
※本記事は、2026年9月28日に取得した公式のモデル一覧・料金ページと、2026年9月30日に確認した Claude Code 公式ドキュメントをもとにしています。
料金・機能・仕様は変更される場合があります。
最新情報はAnthropic公式でご確認ください。
次に読みたい関連記事
このテーマの全体像: Claudeの使い方・料金・モデルの完全ガイド
あわせて読みたい・姉妹メディア